
Увлекательно рассказываю о моем опыте применения AI в разработке и построении продуктов с LLM под капотом.
Связь: @rodion_m_tg
Чат: @ai_driven_chat
Post #104
1.26K
Этихлид Кратко по выбору модели для разработки

От себя добавлю про выбор оптимальных моделей для кодинга
Их сейчас действительно накопилось какое-то несчетное количество, причем множество их них вполне приличные.
В чем еще сила старой доброй Sonnet 3.7? Все еще в задачах на фронтэнд - на текущий момент, кажется, что она все еще делает наилучший UI/UX. И это подтверждают результаты WebDev Arena. Что интересно - новенькая GPT 4.1 незаметно ее догоняет, так что, господа фронтэдщики, - присмотритесь.
Кроме того, похоже, что Sonnet 3.7 в составе Cursor'а все еще лучшая модель для агентского режима.
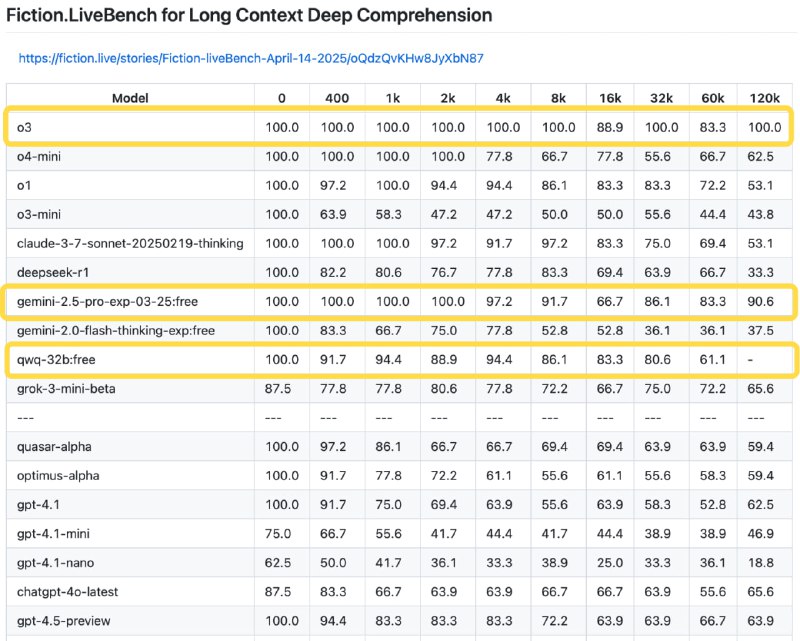
Что насчет больших (и сложных) рефакторингов? Тут, на мой взгляд, лучший выбор - это Gemini 2.5 Pro и o3. Почему? Прежде всего, из-за их максимальной внимательности к контексту (см. бенчмарк Fiction.liveBench). Ну и здесь же вам эксклюзив - обратите внимание на относительно новую модельку QwQ-32B от Qwen - похоже, что она получилась очень удачной - результаты в LiveBench на уровне Sonnet 3.7 (Thinking!), но главное - внимательность к контексту почти на уровне Gemini 2.5 Pro(!). При этом, она еще и опенсорс. Так что, любители поработать с большим контекстом (я) - присмотритесь
Что касается новой модели GPT-4.1 - это хорошая рабочая лошадка для повседневных несложных задач.
Ну, и поделитесь своим опытом, дорогие мои читатели, про o3 - уже столкнулись с ее "странностями" на своем опыте? А то всякие страшилки тут рассказывают про нее в соседних каналах :))
Их сейчас действительно накопилось какое-то несчетное количество, причем множество их них вполне приличные.
В чем еще сила старой доброй Sonnet 3.7? Все еще в задачах на фронтэнд - на текущий момент, кажется, что она все еще делает наилучший UI/UX. И это подтверждают результаты WebDev Arena. Что интересно - новенькая GPT 4.1 незаметно ее догоняет, так что, господа фронтэдщики, - присмотритесь.
Кроме того, похоже, что Sonnet 3.7 в составе Cursor'а все еще лучшая модель для агентского режима.
Что насчет больших (и сложных) рефакторингов? Тут, на мой взгляд, лучший выбор - это Gemini 2.5 Pro и o3. Почему? Прежде всего, из-за их максимальной внимательности к контексту (см. бенчмарк Fiction.liveBench). Ну и здесь же вам эксклюзив - обратите внимание на относительно новую модельку QwQ-32B от Qwen - похоже, что она получилась очень удачной - результаты в LiveBench на уровне Sonnet 3.7 (Thinking!), но главное - внимательность к контексту почти на уровне Gemini 2.5 Pro(!). При этом, она еще и опенсорс. Так что, любители поработать с большим контекстом (я) - присмотритесь
Что касается новой модели GPT-4.1 - это хорошая рабочая лошадка для повседневных несложных задач.
Ну, и поделитесь своим опытом, дорогие мои читатели, про o3 - уже столкнулись с ее "странностями" на своем опыте? А то всякие страшилки тут рассказывают про нее в соседних каналах :))
- 👍 4


