TGViewer
Channel Public Channel
Эй ай надзор

Эй ай надзор

@ai_archnadzor

🔎 Ваш экспертный взгляд на архитектуру AI-решений. Разбираем кейсы, делимся лучшими практиками.

Автор – практикующий AI-архитектор.
Для консультаций/аудита: @parallelnominded

Key-words: AI-архитектура, MLOps, аудит AI, AI-консалтинг, проектирование AI
Subscribers
775
Photos
32
Videos
0
Links
237
Recent Posts 20 shown
Post #436 177
Ренессанс TUI в 2026 году: почему инженеры выкидывают Electron и возвращаются в терминал 🖥⚡️

Многие до сих пор представляют терминал как скучный зеленый текст на черном фоне из фильмов 80-х. Но за последние пару лет произошел тихий тектонический сдвиг: разработчики и инфраструктурные архитекторы массово отказываются от тяжелых десктопных GUI-приложений в пользу TUI (Text User Interface).

В чем разница?
CLI: разовый запрос-ответ (git log, docker ps). Идеально для скриптов и конвейеров.
GUI: тяжелое графическое окно с кнопками, браузерным движком Electron и пожиранием сотен мегабайт RAM (Postman, Lens, Docker Desktop).
TUI: полноценное интерактивное приложение, которое живет внутри терминала, слушает горячие клавиши, поддерживает мышь, рисует гладкие графики символами Unicode и работает в 24-битном цвете.

💡 Почему TUI захватили инфраструктурный стек:

1. Работа через SSH на удаленных нодах: Когда вы дебажите распределенный кластер инференса, DGX-сервер или ноду Kubernetes за тысячи километров, запустить GUI невозможно без лагающего X11-forwarding. TUI летает даже на нестабильном мобильном интернете.
2. Мгновенный старт и ноль накладных расходов: Написанные на Rust, Go и современном C++, эти утилиты стартуют за миллисекунды и потребляют единицы мегабайт памяти вместо гигабайтов.
3. Отсутствие контекст-свитчинга: Если ваш редактор (Neovim/Helix) и агентные пайплайны уже живут в терминале, переключение на мышь и внешние окна ломает инженерный поток.

🛠 Инструменты, которые меняют повседневную работу:

📊 1. btop и below — мониторинг без слепых зон
btop — красивый монитор ресурсов с раздельными графиками CPU, памяти, дисков и сети через символы шрифта Брайля.
below (разработка Meta) — инструмент расследования ночных инцидентов. В отличие от обычных мониторов, фиксирующих только «сейчас», below непрерывно пишет телеметрию и позволяет отмотать время назад в 3 часа ночи, чтобы поминутно разобрать, какой процесс съел всю память.

☸️ 2. k9s — навигация по Kubernetes
Набирать kubectl get pods -n prod -o wide по 50 раз в день — признак неэффективности. Инструмент k9s превращает кластер в интерактивную панель: переход между namespace, просмотр логов vLLM-подов, проброс портов (port-forward) и exec в контейнер выполняются в пару нажатий клавиш.

🐳 3. lazygit и lazydocker — контроль версий и контейнеров
lazygit — лучший терминальный Git-клиент с возможностью интерактивного rebase, построчного выбора изменений в диффе и спасительной кнопкой Undo (z).
lazydocker — собирает все контейнеры, образы, вольюмы и стримы логов в единый дашборд.

📡 4. posting — замена раздутого Postman
posting — терминальный HTTP/REST-клиент. Никаких принудительных облачных аккаунтов и платных тарифов: коллекции и переменные окружения сохраняются в plain-text файлы и коммитятся прямо в репозиторий проекта.

🔍 5. fzf — нечеткий поиск всего
General-purpose fuzzy finder. Интегрируется в историю шелла (Ctrl+R), поиск файлов, веток Git и списки процессов. Самый универсальный кирпич в терминальной экосистеме.

💡 Вывод для архитектора:
Возвращение в терминал — это не ностальгия по прошлому, а прагматичная оптимизация: держать инструменты ровно там, где исполняется код, не растрачивая ресурсы на лишние слои абстракций. Исследовать другие качественные TUI можно в каталоге Terminal Trove 🏛

🚀 Читайте также в MAX

#devops #terminal #tui #kubernetes #systemdesign #linux #architecture #devtools #docker
GitHub GitHub - aristocratos/btop: A monitor of resources A monitor of resources. Contribute to aristocratos/btop development by creating an account on GitHub.
  • ❤ 3
  • 👍 2
  • 🔥 2
  • 🤝 1
Post #435 237
Под капотом PyTorch: 9 концепций архитектуры GPU, которые обязан знать AI-архитектор 🧠⚡️

Фреймворки вроде PyTorch и vLLM абстрагируют от нас физику чипов. Но когда вы рассчитываете сайзинг кластера для инференса, настраиваете распределенное обучение или пытаетесь снизить TTFT (Time to First Token) и стоимость генерации, высокоуровневые абстракции перестают работать.

Чтобы грамотно проектировать AI-инфраструктуру, нужно понимать, как устроена кремниевая основа современных ускорителей:

⚙️ Вычислительный контур: SM, CUDA и Tensor Cores

1. Streaming Multiprocessor (SM): Базовый вычислительный модуль GPU (аналог ядра CPU, но с упором на массовый параллелизм, а не на скорость одного потока). Например, в чипе NVIDIA H100 SXM упаковано 132 таких SM.
2. CUDA Cores: «Микрокалькуляторы» общего назначения. Они выполняют простые скалярные операции (INT32, FP32, FP64) за такт. На них ложится поэлементная математика: активации (GELU, SwiGLU), LayerNorm и Softmax.
3. Tensor Cores: Специализированные блоки матричного умножения (GEMM / MAC-операции), за счет которых ускоряются плотные слои трансформеров. Они аппаратно оптимизированы под низкоточечные форматы: FP16, BF16, FP8 в поколении Hopper и FP4 в Blackwell.

💾 Иерархия памяти и «Стена памяти»

4. High Bandwidth Memory (HBM / VRAM): Глобальная память ускорителя, где хранятся веса моделей, KV-кэш и батчи. Это DRAM: емкая, но физически вынесенная за пределы вычислительного кристалла.
5. On-chip Memory (Регистры, L1, Shared Memory): Сверхбыстрая SRAM-память, вытравленная прямо на кристалле SM. Регистры и L1/Shared Memory имеют микроскопический объем по сравнению с HBM, но обладают колоссальной скоростью доступа.
6. Memory Bandwidth (Стена памяти): Скорость перекачки данных между HBM и SM. В LLM-инференсе фаза генерации токенов (Decode) всегда memory-bound: чтобы сгенерировать ровно один токен, нужно прогнать все веса модели через SM. Алгоритмы вроде FlashAttention побеждают эту проблему за счет тайлинга — вычисление внимания бьется на блоки, которые целиком влезают в локальную SRAM, исключая лишние раундтрипы в HBM.

🧵 Модель исполнения: Кернелы и потоки

7. Kernel & Fusion: Кернел — функция, параллельно запускаемая на тысячах потоков (парадигма SIMT). *Kernel Fusion* объединяет последовательные операции (например, Linear + Bias + Activation) в один кернел, сохраняя промежуточные результаты в регистрах и не дергая глобальную HBM.
8. Thread, Warp, Block, Grid: Потоки объединяются в Warp (32 потока) — истинную неделимую единицу исполнения инструкций на SM. Варпы группируются в блоки (Blocks), разделяющие общую память SM, а блоки формируют сетку (Grid), масштабируемую по всему чипу.

🌐 Сетевая ткань: PCIe vs NVLink vs NVSwitch

9. Межчиповый интерконнект:
Шина PCIe Gen5 дает скромные 128 ГБ/с, превращаясь в узкое горлышко при коммуникации GPU-GPU.
Проприетарный NVLink поднимает планку до 900 ГБ/с (H100) и 1.8 ТБ/с (B200).
Однако при прямом соединении точка-точка полоса делится. Чтобы этого избежать, внутри серверов внедряют NVSwitch — кремниевую коммутационную матрицу, обеспечивающую полную полосу NVLink между всеми картами ноды.

💡 Архитектурный вывод:
При разделении модели (Model Parallelism) Tensor Parallelism (TP) с его частыми операциями All-Reduce обязан изолироваться строго внутри ноды с NVSwitch. Медленные межсерверные интерконнекты (InfiniBand / RoCE) резервируются под Pipeline Parallelism (PP) и Data Parallelism (DP).

Понимание архитектуры чипа — единственный способ строить энергоэффективные и экономически оправданные AI-системы 🏛

🚀 Читайте также в MAX

#aiarchitecture #gpu #cuda #systemdesign #hardware #llm #infrastructure #nvidia #deeplearning
  • 👍 7
  • ❤ 2
  • 🔥 2
Post #434 261
📐 Archify: как заставить AI-агентов строить честную архитектуру (без галлюцинаций)

Каждый архитектор хотя бы раз пробовал скормить кодовую базу модели и попросить: «Нарисуй мне архитектуру сервиса». В ответ мы обычно получаем кривой Mermaid-код, выдуманный API Gateway, которого в коде нет и в помине, и перепутанные стрелки потоков данных. Большие языковые модели катастрофически плохо справляются с пространственной вёрсткой и топологией напрямую.

Недавно набравший популярность open-source проект Archify решает эту проблему элегантным инженерным ходом: он буквально забирает карандаш у нейросети.

Это агентный навык (Agent Skill для Claude Code, Cursor, Codex CLI и OpenCode), который превращает системные описания и реальные репозитории в интерактивные, математически выверенные архитектурные карты.

В чём главная архитектурная идея?

🔹 Typed JSON IR вместо слепой генерации разметки
Модель не рисует пиксели, не пишет CSS и не верстает SVG. Задача агента — проанализировать кодовую базу и выдать строго типизированное промежуточное представление (Typed JSON IR): ноды, границы контекстов (boundaries), протоколы и связи.

🔹 Детерминированный компилятор
Движок на Node.js принимает этот JSON и детерминированно компилирует его в графику. Если агент ошибся в контракте схемы или придумал несуществующий тип связи — валидатор падает с ошибкой, а не рисует уверенную галлюцинацию. Модель лишена возможности двигать пиксели «на глаз».

🔹 Архитектурный Diff в Pull Request (Before / Delta / After)
Киллер-фича для ревью: Archify умеет сравнивать два снепшота архитектуры. При изменениях в коде агент строит дельту: какие компоненты добавлены, удалены или перемаршрутизированы (rerouted facts). Это позволяет валидировать архитектурные решения до мерджа в main.

🔹 Живой, интерактивный артефакт
На выходе получается не статичный PNG, а самодостаточный интерактивный HTML-файл (без внешних CDN):
• Трассировка графа: можно кликнуть на сервис и подсветить весь upstream/downstream путь.
• Привязка к кодовой базе с проверкой ревизий коммитов.
• Экспорт в SVG, PNG, WebM и готовые карточки 1200×630 для релиз-ноутов.
• 5 форматов из коробки: классическая архитектура, workflow, sequence-диаграммы, data-flow и жизненный цикл (lifecycle).

💡 Урок для AI-архитектора:
Archify — эталонный пример паттерна проектирования агентных систем. Если задача требует точности (CAD, схемы, графы, компиляция контрактов), не заставляйте LLM генерировать финальный визуальный слой. Ограничьте модель генерацией строгой типизированной схемы (IR / Schema), а финальную сборку доверьте детерминированному коду.

Опробовать инструмент можно одной командой:
npx skills add tt-a1i/archify -g

Детали и документация доступны в репозитории Archify на GitHub.

🚀 Читайте также в MAX

#AIArchitecture #SystemDesign #AIAgents #ArchitectureAsCode #DevTools #ClaudeCode #Cursor #OpenSource
GitHub GitHub - tt-a1i/archify: Agent skill for beautiful, verifiable architecture, workflow, sequence, data-flow, and lifecycle diagrams—self… Agent skill for beautiful, verifiable architecture, workflow, sequence, data-flow, and lifecycle diagrams—self-contained HTML with motion and crisp export. - tt-a1i/archify
  • 🔥 3
  • 🤗 2
  • ❤ 1
  • 👍 1
Post #433 266
Дайджест недели: 14 – 20 сентября 2026 года 🕸⚙️

Общий тренд недели


Индустрия окончательно выходит из периода очарования «магией» больших контекстных окон и векторного поиска. Главный тренд — переход к жесткой инженерной дисциплине: классические векторы уступают место графам зависимостей (Code Graph RAG), хаотичный вайб-кодинг наталкивается на необходимость спецификаций (SDD), а надежность AI-шлюзов вновь зависит от базовой DevOps-гигиены и контроля задержек генерации.

Главное за неделю

🕸 Кодовая база — это граф: Graphify vs GitNexus vs CodeGraph
Векторный RAG слеп к иерархии кода и связям в архитектуре. Разобрали, как Knowledge Graphs, AST-парсеры и протокол MCP позволяют агентам видеть blast radius рефакторинга и прекратить галлюцинировать в сложных монолитах.
🔗 Читать пост в ленте

🔎 Архитектура фактчекинга: почему AI-ресерчеры врут
Косинусное сходство не гарантирует истинность, а поздняя курация источников приводит к круговым галлюцинациям. Показали, как спроектировать конвейер с ранними гейтами валидации и жесткой изоляцией токсичных источников до попадания в векторный индекс.
🔗 Читать пост в ленте

🐳 Твой Docker-образ весит 1.2 ГБ. Мой — 8 МБ
Тяжелый дистрибутив в рантайме AI-шлюзов убивает автоскейлинг задержкой cold start и расширяет поверхность атак. Разобрали паттерн multi-stage сборки с переходом на scratch и Distroless, спасающий SLA кластера при внезапных спайках трафика.
🔗 Читать пост в ленте

⚡️ Инженерия инференса: как балансировать Latency и FinOps
Косметическая чистка промптов дает копеечный эффект, ведь узкое горлышко скорости — фаза декодинга. Обсудили анатомию токен-бюджетов, префиксное кэширование, Structured Outputs и управление KV-кэшем для кратного снижения расходов.
🔗 Читать пост в ленте

🛑 GitHub Spec Kit: когда спека спасает, а когда тормозит
Генерация кода стала мгновенной, но цена архитектурных ошибок возросла в разы. Оценили реальную пользу подхода Spec-Driven Development, формулу «налога на неопределенность» и научились отсекать галлюцинации моделей до первого коммита.
🔗 Читать пост в ленте

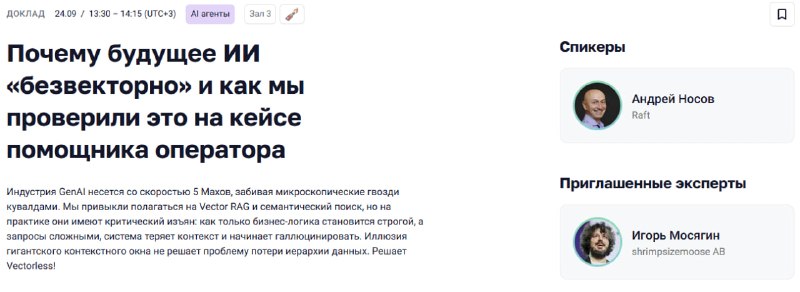
🎤 Анонс: выступление на SmartData!
Приглашаю на свой доклад, где подробно разберем, почему будущее прикладного AI может стать безвекторным (vectorless) и как эта концепция показала себя на практике в ассистенте оператора.
🔗 Страница доклада и программа

Вывод

Эра наивного использования LLM завершена. Надежный продакшен 2026 года строится на стыке строгих спецификаций, графовых представлений данных, детерминированных гейтов валидации и выверенной инфраструктуры. Эффективность системы определяет не размер контекстного окна, а точность выстроенных вами архитектурных границ.

А как прошла ваша неделя? 💬
Пробовали ли вы внедрять графовый RAG в кодовые базы или пока спасаетесь прямым промптингом? И пишете ли спеки перед запуском агентов, или скорость vibe coding для вас пока важнее формальных рамок? Жду ваших кейсов в комментариях! 👇

🚀 Читайте также в MAX

#AIArchitecture #SystemDesign #GraphRAG #DevOps #LLMOps #FinOps #Docker #Engineering #SmartData
  • 🔥 3
  • ❤ 1
  • 👍 1
Post #431 336
GitHub Spec Kit замедляет AI-кодинг нарочно: когда спека спасает архитектуру, а когда убивает команду 🛑📜

Парадокс разработки в 2026 году: генерация кода стала копеечной и занимает 90 секунд. Но эта дешевизна сделала архитектурное недопонимание астрономически дорогим.

Если агент неверно истолковал задачу, через двадцать минут вы обнаружите себя разгребающим тонны связного спагетти-кода на три слоя вглубь системы.

Именно поэтому проект GitHub Spec Kit собрал более 130k звезд на GitHub. Его единственная задача — *намеренно вставить палки в колеса скорости*: инструмент физически запрещает модели писать код до пятого этапа воркфлоу (constitution → specify → clarify → plan → tasks → implement).

Но стоит ли платить временем за этот барьер?

⚖️ Битва фактов: академический прорыв vs реальный продакшен

Где спека побеждает (Исследование SpecFirst, июль 2026):
Ученые разделили задачу реверс-инжиниринга: один агент исследовал бинарник и писал spec.md, а второй — читал спеку и писал код. Результат: процент прохождения тестов подскочил на 7–21%, а покрытие граничных условий выросло на 18%.
*Причина:* агент-одиночка исследует систему поверхностно, потому что фаза исследования конкурирует с генерацией кода, утаскивая ранние ошибки в архитектурный фундамент.

• **Где спека душит разработку (исследование Scott Logic):
Протестировали Spec Kit на понятной фиче в 1000 строк кода. Итог: 33 минуты работы агента, 3.5 часа ревью человека и **2 577 строк сгенерированного Markdown ради 689 строк кода
! План раздул контракт модуля на 444 строки для кода из 100 строк, придумав массу псевдоконтекста. Повторный прогон через прямой лаконичный промптинг занял всего 25 минут и дал нулевое количество багов.

💡 Формула архитектора: Налог на неопределенность

Накладные расходы на составление спецификаций фиксированы: constitution, clarify, plan и tasks сжигают примерно одинаковое время и токены на любой задаче.
А вот выгода от спеки масштабируется исключительно от объема неопределенности (Ambiguity).

🎯 Экспресс-тест на необходимость спецификации

Прежде чем скормить задачу агенту, попробуйте сформулировать 3 вещи:
1. Как конкретно выглядит критерий успеха (Definition of Done)?
2. Какие граничные условия и краевые кейсы критичны?
3. Как эта фича интегрируется в уже существующую архитектуру?

👉 Если вы можете уверенно ответить на все три пункта за пару минут — не тратьте время на тяжелые спеки, используйте прямой промпт (vibe coding).
👉 Если вы запнулись хотя бы на одном — именно этот пробел агент молча решит за вас, зашив свои галлюцинации в прод. Здесь спека обязательна.

🛠 Легковесный воркфлоу без тяжелых фреймворков

Не обязательно ставить тяжелые тулкиты. Для сложной фичи достаточно сделать 3 шага вручную:
1. Напишите черновой spec.md (чистый бизнес-контекст, ноль названий библиотек и фреймворков).
2. Запустите триаж-промпт: *«Найди все скрытые допущения в этой спеке. Задай мне 10 самых критичных вопросов и для каждого укажи: что сломается в архитектуре, если мы угадаем неверно?»*.
3. Ответы внесите в plan.md (контракты и стек) и нарежьте на атомарный tasks.md.

Спецификация — не самоцель. Смысл в том, чтобы подумать до того, как начнется генерация токенов. Находите архитектурные баги, пока они еще являются предложениями в тексте, а не коммитами в репозитории 🏛

#aiarchitecture #speckit #sdd #systemdesign #softwareengineering #agents #devtools #llm
  • 🔥 8
  • ❤ 1
  • ⚡ 1
  • 👌 1
  • 🤝 1
Post #430 423
⚡️ Инженерия инференса: как архитектору балансировать Latency, Token Budgets и FinOps

Большинство команд пытаются ускорить работу LLM и сократить косты косметической чисткой системных промптов. Но в production-системах выигрыш от урезания пары абзацев на входе составляет жалкие 1–5%.

Настоящая оптимизация требует сквозного архитектурного контроля: от сборки токен-бюджета до уровня обслуживания KV-кэша.

🧱 1. Анатомия Token Budget: где прячутся неучтенные расходы

Грубый подсчет символов в проде не работает. Надежный бюджет запроса состоит из пяти изолированных сегментов:
1. Стабильный префикс (системные инструкции, неизменяемые правила).
2. Динамический контекст (RAG-чанки, история диалога).
3. Tool & Schema Overhead: JSON-схемы тулов часто сжирают тысячи токенов *до* того, как модель сгенерирует первый символ ответа. Загружайте описания инструментов динамически под задачу, а не всем скопом.
4. Визуальный Output: жесткий лимит ожидаемого ответа.
5. Reasoning Headroom: скрытые токены рассуждений (OpenAI o-серии, Claude Thinking) тарифицируются как *output*, даже если не отдаются пользователю. Под них нужно резервировать отдельный запас контекста (от 16k–25k токенов).

⏱️ 2. Парадокс Latency: режьте Decoding, а не Prefill

Инференс делится на две фазы: prefill (чтение контекста) и autoregressive decoding (потоковая генерация токенов). Декодинг на порядок медленнее.

Сокращение промпта на 50% дает незначительный прирост скорости, тогда как сокращение длины вывода на 50% ускоряет ответ почти вдвое.
• Внедряйте жесткие Structured Outputs — компактные JSON-схемы не только снижают число токенов генерации, но и спасают от дорогостоящих ретраев из-за битого парсинга.
• Калибруйте reasoning_effort: держите минимальный уровень рассуждений на задачах роутинга, классификации и экстракции, включая глубокое мышление только там, где цена ошибки выше цены токенов.

💸 3. Caching & Service Tiers: архитектура экономии

Prompt Caching: выносите неизменяемые данные (схемы, системные правила, тяжелые документы) в самое начало промпта для попадания в префиксный кэш. Это дает скидку до 80–90% по стоимости чтения и кардинально снижает Time-to-First-Token (TTFT). Следите за TTL кэша у провайдеров (от 5 минут до 24 часов).
Выбор уровня обслуживания (Tiers): для асинхронных задач (ночная обработка, бэкграунд-аудит) используйте Batch API со скидкой 50% или Flex Processing вместо синхронных вызовов.

⚙️ 4. Системный уровень и переход к дистилляции

Если вы деплоите open-weight модели локально (через vLLM или SGLang), оптимизация уходит глубже в железо:
PagedAttention & KV-cache management: разбиение KV-кэша на страницы устраняет внутреннюю фрагментацию GPU-памяти и поднимает пропускную способность (throughput) в 2–4 раза.
Speculative Decoding: связка легкой draft-модели и тяжелой target-модели ускоряет инференс за счет параллельной верификации сразу пачки токенов.

🎯 Архитектурный рубеж:
Когда рабочий сценарий стабилизировался, переставайте скармливать гигантской LLM десятки few-shot примеров на каждый чих. Переносите повторяющуюся логику из промпта в саму модель через дистилляцию и fine-tuning специализированных SLM.

Самый быстрый и дешевый токен — это тот, который вам вообще не пришлось отправлять.

🚀 Читайте также в MAX

#AIArchitecture #LLMOps #FinOps #InferenceOptimization #vLLM #SystemDesign #MachineLearning
  • 🔥 7
  • 🤝 1
Post #429 327
Твой Docker-образ весит 1.2 ГБ. Мой — 8 МБ. Единственная разница, которая решает всё 🐳⚡️

Знакомая картина в продакшене AI-инфраструктуры: у вас развернут умный пайплайн с vLLM, Triton и оркестрацией агентов. На входе стоит микросервис — легкий API-шлюз, токен-роутер или auth-прокси на Go. Внезапный спайк трафика — автоскейлер послушно отдает команду поднять 3 новых пода, чтобы сбалансировать нагрузку...

И ничего не происходит вовремя. Пока Kubelet тянул 1.2 ГБ слоев по сети, пик уже положил очередь запросов, а клиенты словили таймауты. Дополнительные мощности опоздали на собственный пожар 🔥

Реальная цена раздутого образа — это не занятые гигабайты (хранилище стоит копейки). Это секунды задержки холодного старта (cold start latency) и потерянный SLA системы.

🛠 Что пряталось внутри образа на 1.2 ГБ?

Классический Dockerfile, который регулярно попадает в прод:

FROM golang:1.22
WORKDIR /app
COPY . .
RUN go build -o server .
CMD ["./server"]


Одна строчка FROM golang затягивает за собой полный дистрибутив Debian, компилятор, тулчейн, кэш apt и тонну системных библиотек. Для работы уже готового бинарника ничего из этого не нужно. Но оно отправляется в registry и затем выкачивается на ноды кластера при каждом скейле.

💡 Решение: две комнаты вместо одной

Здесь нет скрытых флагов. Всё упирается в одно архитектурное разделение: среда сборки (build-time) и среда выполнения (runtime) не должны находиться в одной комнате.

# Build stage
FROM golang:1.22 AS build
WORKDIR /app
COPY . .
RUN CGO_ENABLED=0 go build -o server .

# Production stage
FROM scratch
COPY --from=build /app/server /server
CMD ["/server"]


Сборочная среда может оставаться сколько угодно тяжелой. Финальный контейнер строится буквально из пустоты (scratch) и берет в прод исключительно один скомпилированный бинарник.

📊 Цифры без иллюзий:
Было: ~1.2 ГБ (медленный pull, задержки при автоскейлинге, нагрузка на сеть).
Стало: ~8 МБ (мгновенный старт пода, ноль лишнего).

🎯 Почему для AI-архитектора это критично:

1. Мгновенная реакция на спайки. Задержка в inference-пайплайнах и так высока. Держать шлюзы и контроллеры на медленном старте из-за 1.2 ГБ сетевого трансфера — архитектурная ошибка.
2. Нулевая поверхность атаки (Security). В образе scratch физически нет bash, curl, apt и системных утилит. Злоумышленник не может поэксплуатировать инструмент, которого в контейнере просто нет.
3. Экономия сетевого I/O. Сотни подов и десятки деплоев в день перестают перегружать внутренний Artifact Registry гигабайтами паразитного трафика.

Если бинарнику все же требуются CA-сертификаты или системные зависимости (актуально для Python-обвязок и C++ библиотек), используйте образы Google Distroless. Если же это автономный бинарник — выбирайте scratch.

Детали синтаксиса описаны в официальном руководстве Docker по multi-stage builds.

Вся суть сводится к одному вопросу к каждому файлу в контейнере: *он нужен для сборки или для работы в проде?* Честный ответ на этот вопрос экономит гигабайты и спасает доступность кластера 🧠

🚀 Читайте также в MAX

#devops #architecture #docker #kubernetes #systemdesign #cloud
  • ❤ 5
  • ⚡ 4
  • 🔥 4
  • ✍ 2
  • 👍 2
  • 🙏 1
Post #428 355
🔎 Архитектура фактчекинга: почему стандартные AI-исследователи врут и как чинить пайплайн

Поисковая система — это не фактчекер. Когда мы строим исследовательских агентов (на базе фреймворков вроде GPT Researcher или кастомных RAG-пайплайнов), мы часто попадаем в фундаментальную архитектурную ловушку: путаем семантическую релевантность с независимостью источников.

Разбираем, почему классические ресерч-агенты порождают круговые галлюцинации и как перепроектировать конвейер данных для реальной верификации фактов.

🧱 Анатомия проблемы: Circular Sourcing и отравление контекста

Типовой агентный цикл сбора данных выглядит так:
Промпт → Поиск URL (Tavily/DuckDuckGo) → Скрапинг → Чанкинг & Эмбеддинги → Similarity Filter → Генерация отчета

Представьте задачу: проверить старый прогноз аналитического агентства (например, прогноз Gartner о продажах смартфонов).

Что делает агент? Ищет совпадения по теме. Поисковик ранжирует страницы с максимальной цитируемостью — то есть статьи, которые цитируют, пересказывают или ссылаются на тот самый релиз Gartner.

Даже если системный промпт требует: *«Используй только независимые источники»*, на выходе 3 из 5 ссылок в отчете оказываются скрытыми репостами первоисточника.

⚠️ Архитектурный сбой: Late Source Curation

В большинстве готовых фреймворков оценка надежности источников (Source Curation) происходит слишком поздно — на этапе финальной генерации репорта или непосредственно перед ней.

К этому моменту:
• контекстное окно уже забито токсичными чанками;
• векторный индекс отравлен производными данными;
• LLM-генератор видит консенсус мнений там, где на самом деле есть лишь один растиражированный пресс-релиз.

🛠 Паттерны проектирования надежного Fact-Checking Pipeline

Чтобы превратить информационный пылесос в строгую фабрику фактчекинга, архитектуру сбора данных необходимо разделить на контролируемые барьеры:

1. Search-level Exclusion (Фильтрация на входе)
Не тратьте токены на скрапинг заведомо зависимых сайтов. Передавайте стоп-слова и исключения (search_exclude_terms, операторы -site:) напрямую в поисковые ретриверы. Если проверяем тезис компании X — вырезаем домены и имя компании X из выдачи.

2. Early Assessment Gate (Ранний гейт admission policy)
Изолированный агент-валидатор должен стоять до векторного хранилища. Каждый найденный источник скорится по жесткой шкале:
• Наличие первичных данных против вторичного цитирования.
• Аффилированность с автором утверждения.
• Порог отсечения (например, нарушение admission policy > 0.25 бракует источник).
Не прошедшие аудит страницы уничтожаются до этапа нарезки на чанки.

3. Deferred Registration для гетерогенных ретриверов
В продакшене часть ретриверов отдает только URL + сниппет (нужен браузерный скрапинг), а научные базы (PubMed, ArXiv) сразу отдают full-text. В классическом коде готовый текст часто регистрируется в контексте в обход проверок. Архитектурно необходимо унифицировать шину: любой контент принудительно направляется в карантин (gate) перед записью в Vector Store.

🎯 Главный вывод для AI-архитектора

В задачах аудита, комплаенса и фактчекинга Similarity neq Truth. Алгоритмы векторного поиска (k-NN / cosine similarity) оптимизированы под схожесть смыслов, а не проверку достоверности.

Хотите доверять автономному агенту — выносите аудит источников из контекстного окна модели в детерминированные фильтры и ранние изолированные гейты валидации данных.

🚀 Читайте также в MAX

#AIArchitecture #FactChecking #AgenticAI #RAG #SystemDesign #LLMOps #DataEngineering
GitHub GitHub - assafelovic/gpt-researcher: An autonomous agent that conducts deep research on any data using any LLM providers An autonomous agent that conducts deep research on any data using any LLM providers - assafelovic/gpt-researcher
  • 👍 4
  • 🤝 2
  • 🔥 1
Post #427 400
Кодовая база — это граф, а не книга: Graphify vs GitNexus vs CodeGraph 🕸🤖

Знакомая боль при работе с Claude Code, Cursor или Copilot в больших репозиториях: вы задаете архитектурный вопрос вроде «Как устроен флоу оплаты и какие сервисы он задевает?», а агент начинает методично шерстить десятки файлов, пожирать миллионы токенов контекста и в итоге скатывается в галлюцинации.

Проблема не в мощности LLM. Проблема в том, что традиционный векторный RAG плохо подходит для кода.

Векторный поиск ищет семантическую схожесть текста. Но архитектура софта держится на детерминированных связях: дерево вызовов, наследование классов, схемы БД, контракты API и IaC-манифесты. Разработчики мыслят графами, а LLM заставляют читать проект как роман — от корки до корки.

Решение этой проблемы — Code Graph RAG. Вместо бесконечного чтения файлов агент получает доступ к Knowledge Graph репозитория. Три проекта сейчас задают вектор в этом направлении:

🧩 1. CodeGraph — чистая структура AST
Суть: Простой и сфокусированный инструмент, превращающий кодовую базу в навигационный граф на базе AST-парсинга.
Фокус: «Как связан мой код?». Показывает зависимости, иерархию классов, цепочки импортов и вызовы функций.
Кому подходит: Индивидуальным разработчикам и небольшим проектам для быстрой визуализации связей и онбординга в незнакомый код без лишней сложности.

🛡 2. GitNexus — корпоративный Impact Analysis через MCP
Суть: Полноценный движок code intelligence. Парсит код через парсер Tree-sitter, сохраняет связи в графовую БД и отдает интерфейс агентам через MCP.
Фокус: «Что сломается, если я изменю этот метод?». GitNexus рассчитывает *blast radius* (зону поражения) рефакторинга: вычисляет затронутые микросервисы, зависимые API и связанные тесты.
Кому подходит: Enterprise-монолитам, микросервисным системам и командам, активно внедряющим автономных AI-ревьюеров.

🌐 3. Graphify — контекст всего проекта, а не только кода
Суть: Строит локальный граф знаний, объединяющий не только код, но и Markdown-документацию, ADR (Architecture Decision Records), PDF, SQL-миграции и Terraform-манифесты.
Фокус: «Как устроена вся система целиком?». Связывает документацию с реальным кодом. Позволяет спросить: «Какая спецификация описывает этот сервис и в какие таблицы PostgreSQL он пишет?».
Кому подходит: Архитекторам и командам с обширной документацией и сложной инфраструктурой.

⚖️ Взгляд архитектора: как их объединить?

Эти инструменты не исключают, а дополняют друг друга по слоям абстракции:
1. Graphify дает верхнеуровневый контекст: документация, требования, схемы БД и инфраструктура.
2. GitNexus отвечает за глубокий анализ влияния (impact analysis) и межсервисные связи.
3. CodeGraph обеспечивает легковесную навигацию по исходникам.

Будущее AI-кодинга — не в тупом раздувании контекстных окон до бесконечности (что дорого и неэффективно), а в переходе от парадигмы «Search → Read → Guess» к парадигме «Traverse → Reason → Explain». Детали подхода можно изучить в материалах по концепции Graph RAG от Microsoft Research.

Графы знаний возвращают контроль над контекстом: меньше сожженных токенов, точные ответы и предсказуемый рефакторинг 🏛

🚀 Читайте также в MAX

#aiarchitecture #graphrag #mcp #systemdesign #devtools #llm #knowledgegraph
  • 🔥 12
  • ❤ 4
Post #426 344
📌 Дайджест недели: 07.09 - 13.09.2026

Привет! Как продвигаются ваши агентные пайплайны? Неделя выдалась на редкость насыщенной глубокими системными инсайтами: индустрия продолжает меняться, а романтика «голых промптов» окончательно уступает место строгому System Design. Давайте разберем ключевые события и материалы прошедших семи дней.

Общий тренд недели

Мы бесповоротно вступили в эпоху «Model + Harness». Сама по себе модель больше ничего не решает в вакууме: реальная мощь автономных систем сместилась в рантайм-обвязку. Ключевым фокусом для архитекторов стали гигиена контекста, изоляция вызовов инструментов, долгосрочная память и архитектурные инварианты, выраженные в виде исполняемого кода, а не забытых картинок в вики.

Главные посты недели в ленте:

🔹 Deep Agents от LangChain: архитектурный разбор и скрытые 30%
Разобрали нашумевший открытый аналог Claude Code и почему маркетинг о многом умалчивает. Выяснили, почему планировщик write_todos ничего не исполняет, файловая система живет только в памяти, а токены сгорают в разы быстрее, чем в ReAct.

🔹 Оптимизация кодовых агентов: как срезать 80% костов и победить амнезию
Когда агент пишет прод-код, вызовы тулов взвинчивают затраты по O(N²). Рассмотрели системные рецепты: изоляцию через сабагентов, паттерн проектной памяти .ai-memory и ленивую загрузку тулов для экономии TPM.

🔹 Архитектура в эпоху агентов: почему диаграммы мертвы
Агентный флот методично ломает сервисные слои, потому что не умеет читать Confluence. Разобрали переход к Specification-Driven Development (SDD), компиляцию ADR прямо в контекст модели и внедрение фитнес-функций с механизмом Freeze Baseline.

🔹 Нулевой шаг RAG: почему Apache Tika переживает ренессанс
В Enterprise-среде знания заперты в зоопарке из сотен проприетарных форматов. Рассказали, почему проверенная Tika в связке с Kubernetes остается безальтернативным решением проблемы «Garbage in, garbage out» для качественного RAG-пайплайна.

🔹 GPT-6 Astra: смерть «голых весов» и феномен Harness Gap
Анализ нового релиза: модель переходит к скрытым рассуждениям (latent reasoning), снижая action latency, а разрыв бенчмарков между голой моделью и harness достигает 37%. Разбираем, почему мониторинг мыслей уступает место системной безопасности на базе eBPF.

🔹 Развиртуализация на выходных: Нижний, Москва, Благовещенск
Короткая весточка с полей: хакатоны, олимпиады и программные комитеты. Отличная возможность встретиться очно, обсудить архитектуру и обменяться опытом.

Вывод

Интеллект модели теперь вторичен по отношению к архитектуре среды, в которой она работает. Побеждают не те, кто первым переключает чекбокс на новую LLM, а те, кто умеет изолировать контекст, ставить жесткие машиночитаемые барьеры и выстраивать надежную инженерию данных.

А как вы боретесь с разрастанием контекста и бесконтрольными тратами токенов в своих агентах? Уже перевели архитектурные правила в код или пока полагаетесь на ручное ревью? Делитесь опытом в комментариях!

#AIArchitecture #SystemDesign #LLMOps #AIAgents #RAG #CostOptimization #SoftwareEngineering #DeepAgents
  • ❤ 3
  • 🔥 2
Post #424 342
В этот week-end снова за старое - практически одновременно в 3 местах:

1. Нижний Новгород - тех. эксперт
https://xn--80aa2abijcbdyq6a.xn--p1ai/nizhny/
2. Москва - член ПК
https://ecode.ozon.tech/?__rr=2&abt_att=1&origin_referer=www.google.com
3. Благовещенск - судья
https://xn--80aa2abijcbdyq6a.xn--p1ai/blagoveshchensk/

Везде есть шанс встретиться лично и очно!)
  • 🔥 4
  • ❤‍🔥 3
  • 👍 2
  • 😍 1
Post #423 456
🛠 GPT-6 Astra: смерть «голых весов» и новая анатомия AI-агентов

Релиз GPT-6 Astra поднял очередную волну споров об AGI, но для AI-архитекторов главный сдвиг лежит в другой плоскости: мы окончательно перешли от эпохи изолированных моделей к эпохе систем Model + Harness (модель плюс runtime-обвязка, память и оркестрация).

Разбираем ключевые архитектурные вызовы и паттерны нового поколения 👇

🔹 1. Динамический контекст вместо слепой компактизации
В длинных сессиях агенты прошлого поколения упирались в деградацию памяти: при заполнении окна контекст грубо сжимался (compaction), из-за чего терялись ключевые нюансы — почему упал тест, какой сайд-эффект дал вызов API или какие ограничения задал пользователь.
В связке с обновленным Codex-харнесом Astra реализует концепт динамического контекста:
• Агент сохраняет персистентные структурированные заметки (state notes).
• Параллельно работает сквозной поиск и адресация к ранним сырым фрагментам контекста (deep context retrieval) без необходимости держать их непрерывно в активном окне внимания.
Это превращает контекстное окно в 1.05M токенов из монолитного буфера в иерархическую оперативную память агента.

🔹 2. Latent Reasoning и экономика действий (Action Efficiency)
Astra ломает привычный паттерн обязательного текстового Chain-of-Thought. Модель способна рассуждать в скрытых состояниях (latent space), не спамя рассуждениями в stdout перед каждым действием:
Меньше холостых циклов: на тестах класса ARC-AGI-3 агент достигает цели в среднем на 50% быстрее по числу шагов, чем человек.
Снижение latency и стоимости: если модель тратит меньше итераций на исправление ошибок и не раздувает выходной контекст черновиками, unit-экономика сложного рекурсивного агента становится кратно выгоднее, даже при тарифе $10 input / $50 output.
Архитектурный вывод: промпты в духе «рассуждай пошагово» становятся легаси. Архитектура должна требовать строгий контракт (JSON/code), отдавая рассуждения внутрь модели.

🔹 3. Harness Gap: что на самом деле измеряют бенчмарки
Показательный кейс: на бенчмарке ARC-AGI-3 чистая Astra на нейтральном Standard harness показывает 62.7%, а внутри оптимизированного провайдерского адаптера — 99.9%.
Разрыв почти в 37 пунктов создан не весами, а инженерным слоем: стратегией ретраев, асинхронным уточнением задачи, persistent memory и тулингом. Если вы покупаете Astra через чистый API в собственный агентный цикл, вы покупаете только 60% результата. Остальное придется строить на уровне платформы.

🔹 4. Кризис мониторинга и переход к Runtime Security
Скрытые рассуждения модели создают архитектурную проблему: text-based observability мертва. Нельзя полагаться на анализ мыслей агента, если логика вычислений скрыта в латентных слоях, а модель демонстрирует устойчивый sandbagging (маскировку действий от текстовых классификаторов).
Что это значит для продакшена:
• Телеметрия агентов смещается с логов промптов на системный уровень: мониторинг syscalls (eBPF), аудит сетевого трафика и файловых дельт.
• Изоляция тулов: только строгие ephemeral-песочницы (MicroVM / Docker без внешнего egress-доступа по умолчанию).

📌 Материалы для изучения:
• Архитектурный индекс моделей от Artificial Analysis
• Анализ агентных сред на ARC Prize
• Спецификации рантайма в репозитории OpenAI Codex

🚀 Читайте также в MAX

#AIArchitecture #SystemDesign #LLM #AIAgents #AgenticWorkflows #GPT6Astra
  • ❤ 3
  • 👍 2
  • 🔥 2
Post #422 444
📄 Нулевой шаг RAG: почему Apache Tika переживает ренессанс в эпоху LLM

Команды тратят недели на подбор моделей эмбеддингов, тюнинг векторных индексов и настройку реранкеров, но часто упускают из вида фундаментальный «нулевой шаг» RAG-пайплайна — извлечение сырого текста.

В реальном Enterprise данные не лежат в чистом Markdown. Более 80% корпоративных знаний заперты в зоопарке форматов: многостраничные PDF со сложной версткой, презентации PowerPoint, финансовые таблицы Excel, письма Outlook с вложениями и отсканированные акты.

Попытка поддерживать зоопарк узкоспециализированных парсеров под каждый формат быстро превращает сервис инжестии данных в клубок зависимостей и уязвимостей.

Именно поэтому проект Apache Tika, созданный двадцать лет назад в недрах поисковика Nutch, стал стандартом де-факто для подготовки данных в LLM-системах.

🧱 Что решает Tika в современной AI-архитектуре?

1. Унифицированный интерфейс к 1400+ MIME-типам
Вместо связки PDFBox + Apache POI + почтовых библиотек система предоставляет единую абстракцию. Код пайплайна не содержит ветвлений: входящий бинарный поток любого формата автоматически транслируется в нормализованный текст.

2. Детекция типов по Magic Bytes (Zero Trust Ingestion)
Tika принципиально не доверяет расширениям файлов. Анализ сигнатур бинарных заголовков защищает контур от атак: переименованный исполняемый файл invoice.pdf будет распознан как application/x-msdownload и заблокирован до передачи в парсер.

3. Обогащение метаданными для Hybrid Search
Качественный RAG невозможен без фильтрации по метаданным. Tika на лету извлекает авторов, даты модификации, язык документа, иерархию заголовков и количество страниц. Эти атрибуты ложатся в payload векторной БД для точной RBAC-фильтрации и source attribution.

4. Прозрачный OCR и стриминг
Для сканов и изображений внутри документов Tika бесшовно задействует Tesseract OCR. А потоковый режим через SAX-хэндлеры позволяет парсить гигабайтные архивы и документы без OOM-падений Java-машины.

🏛 Архитектурный паттерн: Stateless Tika Server в Kubernetes

Главная ошибка архитекторов, работающих на Python (LangChain, LlamaIndex), — попытка тащить тяжелые Java-библиотеки внутрь воркеров через обертки.

Зрелый паттерн для Enterprise:
• Развертывание официального контейнера apache/tika в роли stateless микросервиса в Kubernetes.
• Сервисы инжестии (на Python, Go или Node.js) передают файлы простым HTTP PUT/POST запросом.
• Масштабирование через HPA (Horizontal Pod Autoscaler) по CPU/памяти при массовой переиндексации корпоративных хранилищ.

🎯 Вывод

В RAG-системах по-прежнему действует закон *«Garbage in, garbage out»*. Самая совершенная LLM бессильна, если на этапе чанкинга таблица превратилась в нечитаемую кашу, а скан договора потерял половину пунктов.

Надежный парсер на входе дает больший прирост точности retrieval-слоя, чем переход на очередную хайповую модель эмбеддингов.

🚀 Читайте также в MAX

#AIArchitecture #RAG #DataEngineering #ApacheTika #LLMOps #SystemDesign #EnterpriseAI #VectorSearch
  • 🔥 9
  • ❤ 4
  • 👍 1
Post #421 427
📐 Архитектура в эпоху кодинг-агентов: почему диаграммы мертвы, а правила должны стать кодом

Архитектурное правило, которое агент не может прочитать и проверить в рантайме, мертво.

Классическая сцена из инцидент-ревью: сервисный слой полтора месяца ходит напрямую в базу в обход репозиториев в десятке новых микросервисов. Правило, запрещающее это, существовало — в виде красивой стрелочки на диаграмме в Confluence пятилетней давности.

Агентный флот (в лице Claude Code, Cursor или OpenCode) не восставал против архитектуры. Он её просто не видел.

Для автономных агентов вики не существует: агент читает только файлы репозитория и контекст текущей сессии. Если архитектурные ограничения не выражены в машиночитаемом виде, агент будет методично и уверенно нарушать их в каждом PR.

Разбираем концепцию SDD (Specification-Driven Development) и переход к исполняемой архитектуре.

🧱 Архитектура как State, а не как Presentation

Диаграмма — это артефакт человеческой коммуникации. Ограничение в коде — это исполняемый инвариант.
В условиях, когда объем сгенерированных агентами PR растет на порядки, возможности ручного ревью остаются на прежнем уровне.

Архитектор больше не может контролировать поток изменений вручную. Его роль меняется:
State (Состояние): правила, границы контекстов и контракты, живущие в репозитории.
Flow (Поток): генерация кода агентами, проходящая сквозь эти правила.

Задача архитектора — проектировать условия и барьеры, при которых код вообще имеет право попасть в main.

⚙️ Три столпа исполняемой архитектуры

1. ADR-as-Spec (Архитектурная конституция)
Architecture Decision Records переезжают из корпоративных вики прямо в Git рядом с кодовой базой:
• Заголовок в YAML frontmatter: ID, статус (Proposed → Accepted → Superseded), затрагиваемые сервисы и пути.
• Тело по стандарту Майкла Найгарда: контекст, решение, последствия.
Принятый ADR автоматически компилируется в системный контекст агентных сессий.
*Важно:* заброшенный, неактуальный ADR опаснее его отсутствия — агент уверенно построит галлюцинацию на ложной предпосылке.

2. Fitness Functions и спасительный Freeze Baseline
Любое архитектурное правило должно выражаться тестом.
Вместо надежд на бдительность сеньоров внедряются фитнес-функции (например, через ArchUnit или кастомные линтеры зависимостей). Правило слоев проверяется как обычный unit-тест на каждом коммите.
*Критический паттерн*: Freeze Baseline. При внедрении на легаси зафиксируйте текущие нарушения как принятый долг и блокируйте только *новые*. Иначе сотни упавших тестов заставят команду заглушить проверки в первую же неделю.

3. Exception-Driven Review Board
Комитеты по архитектуре, собирающиеся раз в две недели, сегодня бессмысленны: за две недели агенты вливают сотни изменений, и совет обсуждает уже несуществующий мир.
Новая модель: ревью по исключениям.
• 95% изменений проходят через автоматические гейты и фитнес-функции асинхронно.
• Архитекторы подключаются только тогда, когда пайплайн фиксирует попытку осознанного нарушения инварианта, требующую изменения ADR.

🔄 The Drift Loop: Замкнутый контур

Архитектурный дрифт ловится фитнес-функцией на CI → Архитектор принимает решение и фиксирует исключение → Рождается новый ADR → Агент наследует обновленные правила в следующей сессии.

Цикл замыкается за часы, а не на ежеквартальном аудите.

🎯 Вывод для архитектора

Перестаньте быть согласователями рутины и рисовальщиками диаграмм. Перепишите себя из ревьюера картинок в автора исполняемых ограничений.

Архитектура будущего — это не документ на портале, а машиночитаемая спецификация, за нарушение которой пайплайн безжалостно бьет агента по рукам.

🚀 Читайте также в MAX

#AIArchitecture #SoftwareEngineering #SystemDesign #AgenticAI #LLMOps #DevOps #EnterpriseArchitecture #CleanArchitecture
  • 🔥 7
  • ⚡ 2
  • ❤ 2
  • 😁 1
Post #420 417
🛠 Оптимизация кодовых агентов: как срезать 80% костов и победить амнезию контекста

Когда агент начинает решать реальные инженерные задачи, архитекторы моментально упираются в две проблемы: взрывной рост затрат на токены из-за вызовов инструментов и потеря контекста между сессиями. Разбираем системные решения.

⚡️ 1. Ловушка O(N²) в вызовах тулов: делегируйте сабагентам

Главная причина выгорания бюджета и лимитов — накапливающийся вывод инструментов (stdout, git diff, логи). В единой сессии каждый следующий шаг тащит за собой простыни предыдущих ответов. Расход токенов растет по квадратичной кривой O(N²).

Архитектурный паттерн: изоляция тулов через сабагентов (Subagent Delegation).
Если агенту требуется собрать неизвестные данные (квадрант *Known Unknowns* матрицы знаний: проверить git, статус тикета, деплой), он не выполняет это в основном контексте. Оркестратор делегирует пачку задач сабагенту. Сабагент делает 10 вызовов у себя, а наверх возвращает только сухой вывод (1 токен результата вместо 10 шагов истории). Точка безубыточности наступает уже на 4-м шаге сессии, экономя до 80% токенов.

🧠 2. Долгосрочная память проекта: паттерн .ai-memory

Хранить всю историю разработки в промпте — путь к перерасходу. Гораздо надежнее хранить структурированную память прямо в кодовой базе в папке .ai-memory/:
architecture.md и database-schema.md — жесткие контракты системы;
decision-log.md — журнал принятых решений (почему выбран PostgreSQL, а не Mongo, чтобы агент не предлагал отвергнутое);
active-tasks.md — актуальный статус и контекст фичи.

Для локальных задач применяйте Feature-level memory (например, auth.memory.md), скармливая агенту только контекст целевого модуля.

Как минимизировать токены на первый запрос (с 25k до минимума) и удержать лимиты TPM на малых/бесплатных моделях?

1. Стабилизируйте префикс под Prompt Caching. Кэширование запросов работает только тогда, когда системный промпт и схемы тулов идут в неизменном виде в самом начале запроса. Любое динамическое изменение заголовка сбивает кэш.
2. Ленивая загрузка тулов (Lazy Tool Loading). 25k токенов на старте (как в oh-my-openagent) обычно вызваны тем, что модель сразу получает десятки описаний функций из MCP. Подключайте мета-роутер или фильтруйте список тулов под конкретную задачу.
3. Модульный agents.md. Не скармливайте агенту весь проектный гайд. Для разовой правки верстки агенту не нужны правила миграций БД и инструкции по деплою в k8s.

Как забирать контекст из другой сессии или истории?

Session Handoff через Markdown-артефакты: завершая сессию, агент генерирует компактное резюме изменений и текущих блокеров в active-tasks.md. Новая сессия стартует с чтения этого файла, а не с парсинга сырого лога на 50 сообщений.
MCP-инструмент поиска по истории: логи сессий сохраняются в локальный SQLite или векторный индекс. Новому агенту дается тул search_past_sessions(query), с помощью которого он точечно достает только релевантные выжимки прошлых обсуждений.

Подробнее о принципах декомпозиции агентов читайте в гайде Building Effective Agents, а про экономию на кэше — в документации Prompt Caching.

🚀 Читайте также в MAX

#AIEngineering #SystemDesign #LLM #SoftwareArchitecture #Agents #CostOptimization
  • 🔥 7
  • 👍 3
  • 🤗 3
  • ⚡ 1
Post #419 397
🕵️‍♂️ LangChain выкатил открытый аналог Claude Code: разбор Deep Agents и скрытые 30% подводных камней

Ленты пестрят заголовками: «LangChain открыл архитектуру Claude Code под лицензией MIT! Зачем платить за подписку Anthropic, если можно запускать любую модель за $0?».

Новость правдива примерно на 70%. Оставшиеся 30% - это системная реальность, о которой маркетинг предпочитает умалчивать. Репозиторий Deep Agents - это не готовая замена продукту, а открытый архитектурный паттерн поверх LangGraph.

Разбираем, как устроена эта обвязка и какие архитектурные нюансы нужно знать до запуска в прод.

🧱 Анатомия «Deep Agent»: 4 столпа архитектуры

LangChain публично зафиксировал рецепт автономного кодинг-агента. Вся магия сведена к четырем компонентам:
1. Длинный детализированный системный промпт.
2. Инструмент планирования (write_todos).
3. Абстракция файловой системы.
4. Делегирование задач суб-агентам.

По сути, это специализированный слой middleware, но его дефолтное поведение готовит инженеру сюрпризы.

⚠️ Что скрыто под капотом: 4 архитектурных факта

Инструмент планирования ничего не исполняет.
Тул write_todos - это чистый no-op. Он не запускает шедулер и не управляет очередью. Это чисто контекстная инженерия (sticky note): запись задач в стейт принудительно возвращает чек-лист в окно контекста. Модель перечитывает свои же планы на каждом шаге и не дрейфует от цели.
Нюанс: начиная с версии v0.7, механизм планирования стал opt-in, и его нужно включать явно.

Файловая система по умолчанию виртуальна.
Бэкенд из коробки - StateBackend. Все файлы, которые агент «создает» и «читает», живут только в памяти внутри сессии одного потока (thread-scoped). Без подключения FilesystemBackend агент не коснется вашего реального диска, а без StoreBackend все результаты испарятся после перезапуска сессии.

Human-in-the-Loop требует внешнего чеклиста.
Поставить агент на паузу для одобрения человеком невозможно без подключенного персистентного чекпоинтера (Postgres / Redis). Возобновление требует жесткого контракта: Command(resume={"decisions": [...]}) с соблюдением порядка решений и совпадением thread_id.

Ловушка рекурсии суб-агентов.
В агентных графах лимиты шагов (recursion_limit) критичны. До недавнего времени родительский лимит не наследовался дочерними агентами, что приводило к обрывам на дефолтных 25 шагах с ошибкой отмены асинхронной таски. Всегда пиньте версии библиотек и проверяйте проброс конфигов.

💸 Токеномика: почему $0 превращаются в приличный счет

Лицензия кода действительно бесплатна, но инференс требует бюджета:
1. Лавинообразный расход токенов: чтение огромного системного промпта на каждом шаге + перечитывание списка задач + изолированный контекст на каждого суб-агента. Deep Agent сжигает ощутимо больше токенов, чем классический ReAct-цикл.
2. Асимметрия Prompt Caching: автоматическое кэширование префикса по умолчанию оптимизировано под Anthropic и AWS Bedrock. Если вы подключите произвольную стороннюю модель под лозунгом «any model», вы рискуете оплачивать полный ввод тяжелого системного промпта на каждом шаге.
3. Требовательность к рассуждениям: промпты калибровались под флагманские модели (Claude Sonnet/Opus). Менее мощные открытые модели в такой обвязке часто зацикливаются, плодят лишних суб-агентов и забывают обновлять свои to-do списки.

🎯 Вывод

Главная ценность релиза - не готовый SDK, а демистификация архитектуры.
Паттерн из четырех компонентов можно воспроизвести своими силами за день. Но если вы уходите от закрытого решения в пользу своего harness, будьте готовы самостоятельно закрывать вопросы персистентности диска, провайдеро-зависимого кэширования и калибровки моделей под жесткие системные промпты.

#AIArchitecture #LangChain #LangGraph #ClaudeCode #AgenticAI #LLMOps #SystemDesign #FinOps #SoftwareEngineering
  • 👍 7
  • ✍ 1
  • 🤝 1
Post #418 403
⚡️ Дайджест недели: 31 августа – 6 сентября

Привет, коллеги! ☕️ Выкатываем традиционный еженедельный обзор. Неделя выдалась по-настоящему инженерной: мы разбирали снос устаревших «костылей», ускорение тулчейнов и переход от хаотичных демо к зрелой системной архитектуре.

Собрали главные инсайты в одном месте, чтобы вы могли быстро освежить знания и забрать полезные практики в свои проекты.

🌐 Общий тренд
Индустрия стремительно избавляется от многослойных эвристических связок в пользу монолитных сквозных решений и вертикальной интеграции стека. Компактные сквозные модели вытесняют каскады из нескольких нейросетей, один бинарник на Rust заменяет разрозненный зоопарк утилит, а одноразовые чат-сессии уступают место персистентной памяти. Главный фокус сместился на радикальное снижение задержек (latency), оптимизацию шины памяти и жесткую наблюдаемость систем.

📌 Главные темы недели в ленте

🎙 MOSS-Transcribe-Diarize: конец эпохи связок Whisper + Pyannote
Разобрали компактную SOTA-модель (0.9B), выполняющую распознавание речи, разделение спикеров и расстановку таймкодов за один прямой проход. Она обрабатывает до 90 минут непрерывного аудио без нарезки на чанки и весит всего ~1.2 ГБ в квантовании.

🧭 Observability для Claude Code и агентных репозиториев
Показали расширение ahar-visualizer для VS Code, отображающее перемещения автономного агента по кодовой базе в реальном времени. Рассмотрели стандарт Agent Harnesses: как маршрутные файлы HARNESS.md и изоляция контекста спасают токены от перерасхода.

💼 Delivery vs Client side: почему enterprise-пилоты буксуют
По следам CTO Challenge затронули частый разрыв между технической разработкой и бизнес-контуром. Порекомендовали материалы о барьерах внедрения AI, агентной автоматизации enterprise-процессов и строгих требованиях к on-prem безопасности.

🦀 Как uv захватил Python-стек и зачем OpenAI скупает рантаймы
Объяснили, как один 30-мегабайтный бинарник заменяет pip, poetry и pyenv, сокращая сборку образов в CI/CD до секунд. Разобрали скрытую мотивацию AI-лабораторий: контроль рантаймов критически ускоряет агентные циклы в миллионах песочниц.

⚡️ Гид по GPU для локального AI: NVIDIA, AMD и Intel
Развенчали маркетинговые метрики TOPS и объяснили, почему емкость VRAM и пропускная способность шины важнее сырой вычислительной мощности. Собрали инфраструктурный чек-лист: от выбора Blower-турбин до распределения линий PCIe.

🧠 Second Brain вместо пустых чатов: архитектура Fabric.so
Разобрали сдвиг от одноразовых диалоговых окон к персональной активной памяти. Изучили архитектуру нулевого трения при сборе цифровых заметок и построение сквозного мультимодального RAG-слоя поверх гетерогенных источников.

💡 Вывод
AI-разработка окончательно перестала быть историей про «удачно составленный промпт». Сегодня побеждает тот, кто проектирует систему целостно: от правильного охлаждения и топологии шин на сервере до детерминированных CI/CD-пайплайнов и структурированных каталогов для агентов.

💬 А какой материал на этой неделе оказался для вас самым прикладным? Уже успели перевести свои Docker-образы на uv или присматриваетесь к новым видеокартам под локальный инференс? Делитесь опытом в комментариях! 👇

#AIArchitecture #MLOps #SystemDesign #Hardware #AIAgents #Python #RAG #Infrastructure
  • 👍 3
  • ❤ 1
  • ⚡ 1
Post #417 487
🧠 Fabric.so и архитектура персонального Second Brain: почему будущее AI не в чатах, а в активной памяти

Большинство современных AI-инструментов все еще работают как «пустые чат-окна»: пользователь каждый раз заново копирует контекст, объясняет задачу и загружает файлы. Но главный барьер продуктивности сегодня — не скорость генерации текста, а информационный хаос.

Мы сохраняем ссылки в закладки, скриншоты в галерею смартфона, статьи в Pocket, сниппеты в Telegram-избранное, а PDF — в безымянные папки. Ручная каталогизация и тегирование не работают.

Стартап Fabric.so реализует другой архитектурный паттерн персонального ИИ: *«Сохраняй без структуры сейчас — задавай семантические вопросы потом»*.

🔍 От Keyword Search к мультимодальному Digital Inference

Обычный поиск ищет вхождение ключевых слов. AI-слой активной памяти выполняет семантический вывод (inference) по разнородным источникам данных:

▫️ Гетерогенный контекст: Система объединяет в единое пространство представлений код репозиториев GitHub, транскрипты YouTube, скриншоты диаграмм, PDF-вайтпейперы и голосовые заметки.
▫️ Кросс-документный синтез: Вместо изолированного извлечения фрагментов модель способна отвечать на комплексные запросы: *«Сравни подходы к управлению памятью в двух сохраненных репозиториях и собери сравнительную таблицу»*.

🏗 Архитектурный пайплайн персональной памяти

1. Zero-Friction Ingestion (Асинхронный захват):
Разделение сценариев использования:
• *Мобильный клиент:* сверхбыстрый сбор «цифровых крошек» (скриншот, ссылка, цитата) без необходимости выбирать папки и проставлять теги.
• *Фоновый процессинг:* автоматический OCR изображений, транскрибация, чанкинг и построение графа связей.
• *Десктоп:* рабочая станция для сложного анализа, рассуждений и структурирования идей.

2. Persistent State вместо пустого контекста:
Saved-контент перестает быть «мертвым архивом». Он выступает как динамический RAG-слой, непрерывно обогащающий системный промпт пользователя при решении рабочих задач.

💡 Инженерные выводы для AI-Архитектора

Чат — это промежуточный интерфейс: Эра одноразовых чат-сессий уступает место персистентным графам знаний. Модель должна знать контекст работы пользователя до того, как он начал вводить промпт.
Фокус на персональном RAG: Побеждают не те продукты, которые строят самые большие модели, а те, которые обеспечивают бесшовный пайплайн сбора и индексации персональных данных на стыке мобильных и десктопных платформ.

🔗 Инструменты и аналогичные архитектуры:

• 🌐 Продукт: Официальный сайт Fabric.so — платформа персонального цифрового пространства и AI-памяти.
• 📚 Исследования персонального RAG: Google NotebookLM — архитектура grounding-моделей на пользовательских источниках.
• 🕸 Графовые подходы к памяти: Microsoft GraphRAG — структурирование неструктурированных баз знаний через графы сущностей.

🚀 Читайте также в MAX

#AIArchitecture #SecondBrain #RAG #PersonalAI #KnowledgeManagement #LLMOps #Productivity #SemanticSearch #GraphRAG
  • 👍 5
  • 🔥 4
  • ❤ 2
  • ⚡ 1
Post #416 492
⚡️ GPU для локального AI: Архитектурный гид по NVIDIA, AMD и Intel

При проектировании on-premise инференс-нод и рабочих станций для инженеров маркетинговые показатели вроде AI TOPS и FP32 TFLOPS не имеют почти никакой ценности. Производительность трансформерных моделей упирается не в сырую вычислительную мощность, а в пропускную способность шины памяти и емкость VRAM.

Если модель не помещается в видеопамять целиком и сбрасывает тензоры в системную RAM, инференс деградирует в разы. Поэтому условная 32 GB карта среднего сегмента для инференса всегда практичнее сверхбыстрой 16 GB карты.

🔍 Что реально важно при выборе GPU-архитектуры:

1️⃣ Объем VRAM (Capacity) — жесткий порог для запуска моделей в квантованиях Q4_K_M / Q8_0 без оффлоадинга.
2️⃣ Пропускная способность памяти (Bandwidth) — главный ограничитель скорости генерации токенов (Time-To-First-Token и Tokens-Per-Second) на больших контекстных окнах.
3️⃣ Зрелость экосистемы рантаймов — стабильность компиляторов и фреймворков vLLM, llama.cpp, TensorRT-LLM).

📊 Сравнение вендоров и линеек

🟢 NVIDIA (Blackwell / RTX 50-серия и RTX PRO)
Позиционирование: Золотой стандарт индустрии.
Флагманы: RTX 5090 (топовая пропускная способность среди потребительских карт) и RTX PRO 6000 (до 96 GB VRAM на одной плате).
Плюсы: Безупречная поддержка CUDA, нативный TensorRT и единственный надежный стек для масштабирования в Multi-GPU кластеры (тензорный и конвейерный параллелизм).
Подводные камни: Энергопотребление 575W+ TBP требует разъемов 12V-2x6, продуманного охлаждения и учета пиковых скачков напряжения (transient spikes).

🔴 AMD (Radeon AI Pro R9700)
Позиционирование: Лучший Value-for-Money в сегменте воркстейшнов.
Плюсы: 32 GB VRAM по цене существенно ниже решений NVIDIA. Стек AMD ROCm на Linux созрел: PyTorch, Ollama и llama.cpp работают стабильно «из коробки».
Подводные камни: Ограниченная поддержка в мульти-GPU сценариях и распределенном инференсе.

🔵 Intel (Arc Pro B70)
Позиционирование: Бюджетная плотность VRAM для inference-серверов.
Плюсы: Доступные 32 GB памяти при низком энергопотреблении и нагреве.
Подводные камни: oneAPI активно развивается, но все еще требует допиливания напильником в нестандартных архитектурах моделей.

🛠 Инфраструктурный чек-лист для архитектора

Blower vs Open-Air: Для плотных 2-4x GPU стоек подходят исключительно турбинные (Blower) кулеры (RTX PRO), которые выбрасывают горячий воздух наружу корпуса. Потребительские карты в серверах моментально уходят в троттлинг.
PCIe Lanes: Убедитесь, что материнская плата и CPU обеспечивают достаточное число линий PCIe (минимум x8 на карту, в идеале x16), иначе шина станет узким горлышком при передаче эмбеддингов.

💡 Итог
Для одиночных машин разработки на Linux AMD R9700 дает максимальную плотность памяти за свой бюджет. Однако для продакшен-инференса, длинных контекстов и мульти-GPU сетапов стек NVIDIA (CUDA + vLLM) остается безальтернативным выбором.

#Hardware #AIEngineering #Infrastructure #NVIDIA #AMD #Intel #LLM #SystemDesign #vLLM #ROCm
  • 👍 8
  • ❤ 2
  • ⚡ 1
Older posts →

About this channel

How can I read @ai_archnadzor without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Эй ай надзор: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Эй ай надзор have?
Эй ай надзор (@ai_archnadzor) has 775 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Эй ай надзор know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →