
🧩 Google уместил поиск по тексту, фото и звуку в 567 МБ — модель работает на телефоне
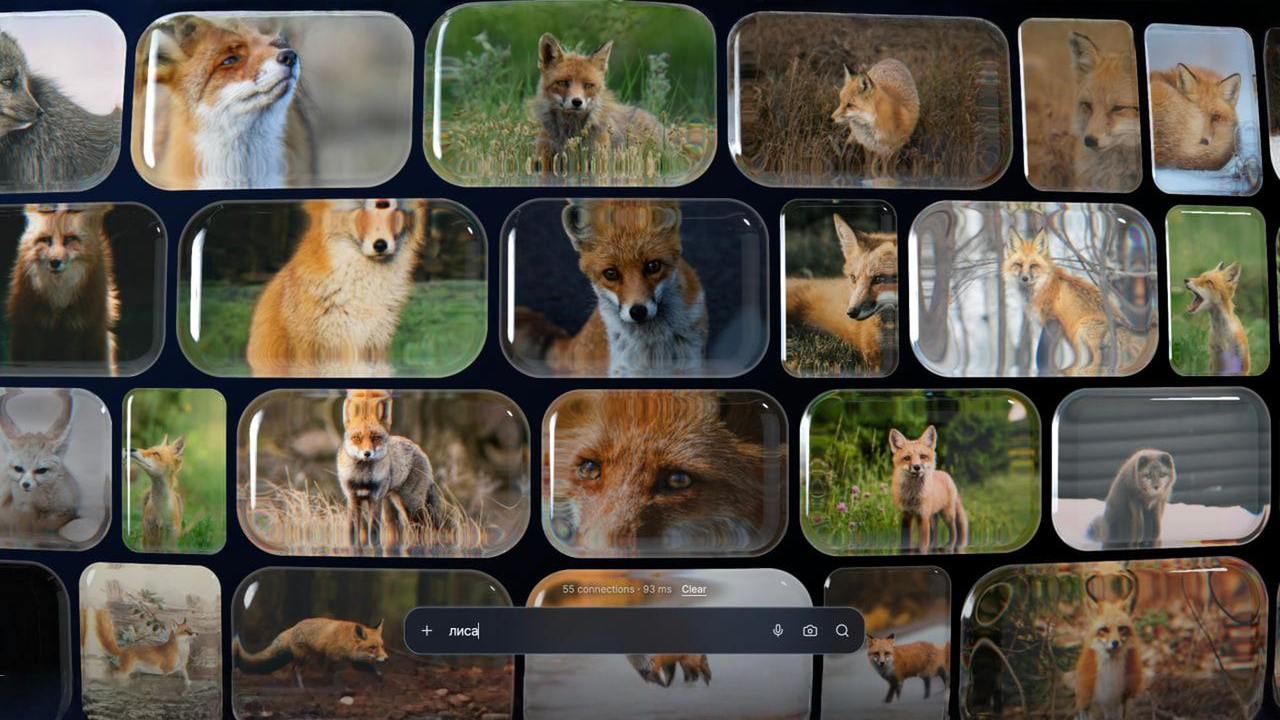
Компания Google DeepMind представила открытую модель EmbeddingGemma 2, которая переводит текст, код, картинки, видео и аудио в единые числовые коды для поиска похожих смыслов. Веса можно скачать и поставить на свой сервер.
Модель весит 740 млн параметров — заметно больше первой версии, хотя точный размер предыдущей модели источник не указывает; известно, что объём обрабатываемых данных у новой версии вырос в 4 раза. Модель собрана из отдельных блоков под текст, изображения и звук — ненужные можно не загружать.
По данным Google, на смартфоне Pixel 11 Pro текстовая часть занимает около 191 МБ памяти, полная версия со всеми форматами — около 567 МБ. Это значит, что поиск по смыслу можно запускать прямо на телефоне, без отправки данных на сервер.
Объём данных, который модель обрабатывает за раз, — 8192 токена, в 4 раза больше первой версии. На задачах с кодом модель обогнала предшественницу на 14%.
Все цифры — собственные замеры Google, независимых проверок пока нет. Для бизнеса с поиском по каталогу товаров или документам на своих серверах — рабочий вариант для теста. Для русского языка точность стоит проверить отдельно: сама Google указывает на разброс качества между языками.
Источник: https://deepmind.google/blog/embeddinggemma-2-an-open-lightweight-multimodal-embedding-model/
💬 Telegram | 💬 MAX
#новости #нейросети #selfhosted
Post #267
240
- 👍 1