TGViewer
Channel Public Channel
Agents Lab

Agents Lab

@agents_lab

Обсуждаем AI агентов

Наш чатик https://t.me/openclaw_lab_community
Subscribers
1.01K
Photos
112
Videos
53
Links
267

Showing posts older than #176 · Back to latest

Older Posts 20 shown
Post #175 999
Вы думали скоро силой мысли будем управлять устройствами? Ну почти...

Всего за 1400$ можно уже купить в US.

Чат | Токены дёшево
  • 😁 7
  • ❤ 2
Post #174 1.03K
10 evals для AI-инженеров: что проверяют и когда использовать 🔄

Evals - это проверки качества AI-агента. Агенту дают задачу и оценивают результат: правильно ли он ответил, какие действия выполнил, не нарушил ли ограничения и сколько ресурсов потратил. По сути, это тесты для AI-систем.

Они делятся на два типа:

- Офлайн-evals запускаются в тестовой среде на заранее подготовленных или прошлых кейсах. Они помогают найти проблемы до релиза.
- Онлайн-evals работают на реальном пользовательском трафике. Они показывают, как агент ведет себя в продукте и действительно ли новая версия стала лучше для пользователей.

Например, регрессионный набор - это офлайн-eval. A/B-тест и теневой запуск - онлайн-evals.

1. Эталонная выборка
Фиксированный набор кейсов, который нельзя менять под новые результаты. Прогоняйте его после каждого изменения, чтобы сразу видеть, стало лучше или хуже.

2. LLM-судья
Вторая модель оценивает ответ агента по заранее описанным правилам. Подходит для открытых задач, где нет единственной правильной строки.

3. Оценка по критериям
Отдельные баллы за точность, стиль, безопасность и стоимость. Помогает понять, что именно просело, вместо одного общего показателя.

4. Оценка траектории
Проверяет не только финальный ответ, но и путь агента: рассуждения, вызовы инструментов и принятые решения. Нужна, когда правильный результат можно получить неправильным и опасным способом.

5. Unit-тесты инструментов
Каждый инструмент проверяется отдельно, на фиксированных данных и без модели в loop. Используйте всегда: многие «ошибки агента» на деле оказываются ошибками инструментов.

6. Регрессионный набор
Старые запуски повторяются с новым промптом или моделью, затем результаты сравниваются. Особенно важно перед изменением промптов, у которых нет системы типов и предсказуемых гарантий.

7. A/B-тест в продакшене
Живой трафик делится между двумя версиями, а сравниваются реальные действия пользователей. Нужен, когда офлайн-оценки перестают предсказывать поведение в продукте.

8. Проверка человеком
Человек оценивает часть запусков вручную. Так можно калибровать LLM-судью и вовремя заметить, что его оценки начали дрейфовать.

9. Теневой запуск
Новая версия работает параллельно на реальном трафике, но ее ответы никто не видит. Полезно перед рискованным релизом, где одна ошибка может дорого обойтись.

10. Red teaming
Агента намеренно атакуют: jailbreak, prompt injection, утечки данных и злоупотребление инструментами. Проводить лучше до появления внешних пользователей, а не после первого инцидента.

Запускать все десять необязательно. Начните с двух проверок, которые могли бы предотвратить ваш последний сбой.

Чат | Токены дёшево
  • 🔥 4
  • ❤ 1
Post #173 3.59K
После loop engineering приходит Graph Engineering. Исследование, планирование, реализация и проверка становятся отдельными узлами, а параллельная работа субагентов уже образует граф.

В 📎Новой статье разбираем, как применять этот подход при разработке репозиториев через Claude Code и Codex: Dynamic Workflows, нативные субагенты, готовые репозитории, worktrees, fan-out/fan-in, независимые проверки и ограниченные циклы исправлений.

Чат | Токены дёшево
  • 😁 3
Post #172 1.03K
Самообучающийся поиск клиентов в Codex ⚡

Компании часто ищут клиентов и предлагают свои услуги. Например, пишут потенциальным заказчикам в Telegram или по email, звонят либо отправляют коммерческое предложение.

В статье показано, как подключить к этой работе Codex. Он смотрит, какие компании ответили, какие сообщения сработали, а какие проигнорировали. Затем предлагает изменить правила выбора клиентов или текст обращения и проверяет правку на примерах.

Codex ничего сам не рассылает. Человек просматривает предложенные изменения и решает, применять их или нет.

📎 Как собрать такую систему в Codex

Кстати, анонсировали сброс лимитов в честь 10 млн юзеров ChatGPT/Codex. OpenAI сделали скачек со своими новыми моделями, увеличив число юзеров в два раза за неделю.
Telegraph Как построить самообучающуюся систему исходящих продаж на Codex В начале года Андрей Карпати поручил агенту улучшать собственный код обучения модели и оставил его работать на два дня. Агент провел 700 экспериментов, сохранил 20 вариантов, превзошедших исходный результат, и ускорил обучение модели на 11%. Из этого следует…
  • 👍 3
  • ❤ 1
Post #171 1.04K
Hermes Agent 0.19.0: быстрее, автономнее и надежнее 🔱

Вышел большой Quicksilver Release: более 2 200 коммитов и 1 000 смерженных PR. Changelog огромный, поэтому собрал изменения, которые заметно влияют на реальные сценарии с AI-агентами.

🔵 Первый ответ приходит примерно на 80% быстрее. Холодный запуск сократили с 4,3 до 0,9 секунды, рассуждения теперь транслируются в реальном времени, а TUI и Desktop обновляют Markdown без тяжелой перерисовки интерфейса.

🔵 За субагентами теперь можно наблюдать. delegate_task сразу возвращает пути к live-транскриптам со всеми вызовами инструментов, результатами и ответами. Завершенный результат сохраняется в state.db и дойдет после перезапуска Hermes, но работающий в момент сбоя субагент заново не запускается.

🔵 Автономность стала безопаснее. Smart approvals теперь включены по умолчанию: отдельная модель оценивает каждую опасную команду, пропускает низкий риск, блокирует высокий и спрашивает пользователя в спорных случаях. Свои deny-правила работают даже в yolo-режиме, а ключи можно загружать из Bitwarden и 1Password вместо хранения всех секретов в открытом .env.

🔵 Один gateway может обслуживать несколько изолированных агентов. Каналы и Telegram-топики разрешено направлять в разные профили с отдельными моделями, навыками, памятью и секретами, сохраняя один bot token. Это упрощает схему, где один профиль пишет код, другой занимается исследованиями, а третий работает как личный ассистент.

🔵 В каталоги добавили GPT-5.6, grok-4.5, Kimi K3, Claude Sonnet 5 и другие модели. А уровни reasoning max и ultra теперь настраиваются отдельно для моделей, вспомогательных задач и MoA.

🔵Историю сессий можно экспортировать в Markdown, HTML и Hugging Face-ready traces с фильтрами и очисткой секретов, поэтому накопленные запуски проще превращать в датасет для анализа и оценки агентов.

Чат | Токены дёшево
  • 👍 8
  • ❤ 1
  • 🔥 1
Post #170 885
Разработчик OpenCode:
Мы заблокировали аккаунт пользователя, управлявшего 8000 мошенническими аккаунтами OpenCode Go.

Они перепродавали токены на сумму 480 000 долларов каждый месяц.

Это сделает ситуацию более устойчивой для легальных пользователей.

Приятной вам недели!


Чат | Токены дешево
  • 😁 8
Post #169 1.07K
AI swarm взломал Hugging Face. Расследовать атаку пришлось другому рою AI-агентов

По данным Hugging Face, злоумышленник использовал автономный агентный фреймворк, который выполнил тысячи действий через рой короткоживущих песочниц. Атака началась с вредоносного датасета, затем агенты получили доступ к узлам, собрали облачные учетные данные и перемещались между внутренними кластерами.

Какая именно LLM управляла роем, неизвестно. Это могла быть взломанная облачная модель или модель с открытыми весами без ограничений.

Самое интересное началось при расследовании. Коммерческие модели отказались обрабатывать настоящие команды атакующего, эксплойты и C2-артефакты из-за защитных фильтров. Поэтому Hugging Face развернула GLM 5.2 локально и отправила собственных агентов разбирать более 17 000 событий. Они восстановили хронологию и последствия атаки за часы вместо нескольких дней, при этом секреты не покидали инфраструктуру компании.

Следов подмены публичных моделей, датасетов, Spaces и пакетов не обнаружено. Но Hugging Face рекомендует сменить токены и проверить активность аккаунта.

Похоже, инфраструктуре AI-компаний теперь нужен собственный защитный агентный рой, готовый работать без внешних API в момент реального инцидента.

Чат | Токены дешево
  • 🤝 3
Post #168 968
Два полезных приёма для вайб-кодинга ⚡

1. Проверяйте решения, а не тысячи строк кода

После выполнения задачи спросите агента:
Какие решения ты принял и в каких не уверен? Что может сломаться и как это проверить?


Для длинных задач попросите вести DECISIONS.md, иначе часть решений потеряется после сжатия контекста. Такой аудит хорошо ловит патчи, которые устраняют симптом, но не причину ошибки.

2. Браузер для разведки, API для работы

Агент может выполнить действие в браузере, записать запросы в HAR и собрать по ним быстрый CLI или клиент. Повторные операции пойдут напрямую через HTTP, без постоянных кликов.

Напоследок ayghri/i-have-adhd 1к ⭐ - skill для ответов Claude Code, адаптированных для людей с СДВГ. Он делает ответы короче и понятнее. На работу агента и качество кода skill не влияет, он меняет только подачу ответа.

Чат | Токены дешево
  • 👍 4
Post #167 926
Почему одна и та же LLM может ответить за секунды или потратить минуты на рассуждение?

Статья о том, как модели учатся режимам low, medium и high, почему максимальное усилие быстро становится дорогим и когда меньшая модель может догнать более крупную за счет дополнительного времени на поиск решения.

📎Как управлять глубиной рассуждений в LLM

Сложная, но интересная статья, советую к прочтению 👍

Чат | Токены дешево
Telegraph Как управлять глубиной рассуждений в LLM Почти два года назад OpenAI выпустила o1 и сделала рассуждающие языковые модели массовой темой. Примерно через четыре месяца появился DeepSeek-R1 вместе с подробным рецептом обучения через обучение с подкреплением и проверяемыми наградами, RLVR. Теперь режимы…
  • 👍 4
  • ❤ 1
Post #166 1.04K
Конкуренция творит чудеса, Claude Fable 5 останется в подписках на тарифах Max и Team Premium с ограничением 50% 🎉

А Pro и Team Standard сохранят доступ к Fable за счет кредитов на использование в размере 100$ (единоразово).

Anthropic понимает, что вы могли фрустрироваться, поэтому ценим невероятный дар в 50% лимитов и надеемся, что они найдут побольше серверов)

Чат | Токены дешево
  • 👍 5
Post #164 951
Что происходит, когда AI-агенты получают доступ к мессенджеру, коду, данным и рабочим процессам всей компании?

В разборе Cerebras Исаак Тай, Дэниел Ким и Майк Гао, команда создателей внутренней базы знаний, показывают систему с 15 000 запросов в день: гибридный поиск, реранжирование, MCP и контроль доступа.

В истории Replit основатель и CEO Амджад Масад вместе со Скоттом Кеннеди описывают «компанию на автопилоте»: loops с субагентами проверяют PR, расследуют инциденты и помогают аналитикам, продажам и поддержке. И поднимают главный вопрос автономности: как доказать, что работа действительно выполнена правильно.

И также из новостей, вышла Kimi K3, которая стала самой большой открытой моделью, на 2.8 трлн параметров. Теперь это реальный конкурент клоду и гпт, немного недотягивающий по мощности, но при этом и подешевле - $3/$15 за 1кк токенов.

Чат | Токены дешево
  • 👍 5
  • ❤ 2
Post #163 1.01K
Вышла новая модель Inkling от Thinking Machines Lab - стартапа Миры Мурати, бывшего технического директора OpenAI.
Модель достаточно средненькая по всем параметрам, но пускай будет.

Кроме того, SpaceXAI открыла исходный код агента Grok Build 8к⭐. Из интересного: CLI не собирает телеметрию и не отправляет ваши данные, за исключением самих промтов.

Чат | Токены дешево
  • 👍 3
Post #162 3.38K
От issue до PR: облачная фабрика разработки 🔥

Cloud Factory Demo 79⭐ собирает цепочку: триаж новых задач → PRODUCT.md и TECH.md для сложных изменений → реализация → проверка PR → внешний loop, который учится на реакции команды.

Шаблон использует Oz Warp, GitHub Actions и скиллы. Каждый этап оставляет проверяемый артефакт, изменения проходят через PR, а среду запуска можно заменить. Верификация и мониторинг пока в плане.

📎 Автоматический триаж задач
📎 Спецификации для сложных задач
📎 Самоулучшающийся агент проверки кода

Автор Зак Ллойд - основатель и CEO Warp, ранее Principal Engineer в Google Docs и CTO Time. Статьи показывают, как команда строит систему, которая ведет работу от issue до проверенного PR.

Чат | Токены дешево
Post #161 1.08K
Pi как оркестратор для Claude Code и Codex

Ben Davis показал свою сборку Pi 453 ⭐. Основная сессия Pi запускает Pi, Claude Code и Codex как полноценных субагентов через единый набор инструментов с отдельными сессиями и общим интерфейсом.

Его рабочий loop:

Claude Code/Fable: исследование и дизайн API → Codex: реализация → свежий Claude Code/Fable: ревью и упрощение

Одновременно могут работать до четырёх подагентов. /subagents показывает модель, заполнение контекста, время, активные инструменты и статус. Можно открыть полный лог, отправить уточнение, остановить запуск или перехватить управление. Готовый результат автоматически возвращается в основную сессию. Свежий контекст ревьюера помогает не унаследовать ошибочное предположение из плана и реализации.

В репозитории также есть JavaScript-workflow с фазами, параллельным запуском и результатами по JSON Schema, фоновые терминалы с /ps, инструменты Firecrawl, ask_user, Git/PR-информация и панель с моделью, контекстом, стоимостью и скоростью генерации.

Слепо копировать не стоит. Claude-подагенты запускаются с bypassPermissions, Codex - с approvalPolicy: never и danger-full-access. Текущий SETUP.md также не ставит зависимости вложенных extensions. После их отдельной установки type-check и все 105 тестов проходят.

Многие говорят, что Pi агент очень хорош, если у нас те кто хочет поделится своим сетапом?

Чат | Токены дешево
  • 👍 2
Post #160 994
У бизнеса с маржой 3% экономия менее 1% выручки может увеличить прибыль примерно на 27%

Главный резерв часто скрыт в «работе вокруг работы»: маршрутах, согласованиях, документах, счетах и разборе исключений. Именно сюда стоит встраивать ИИ-агентов - в существующие ERP, почту и таблицы, с понятными границами и передачей спорных случаев человеку.

📎 Почему бизнес с низкой маржой может выиграть от ИИ больше всех

Чат | Токены дешево
  • 👍 1
Post #159 1.1K
AI coding loop для Hermes 🔱

Он убирает постоянное сопровождение агента и оставляет человеку две задачи: описать идею и проверить готовый результат.

Работает так:

1. Создаём три skills: /spec, /build и /review.

2. Запускаем /spec "идея". Hermes задаёт уточняющие вопросы, а затем сохраняет подробное задание в Markdown-файл: что сделать, какие есть ограничения и как проверить результат.

3. Cron-задача /build регулярно проверяет папку со спецификациями. Находит новую задачу, пишет код, запускает тесты и меняет статус в том же файле на review.

4. Другая cron-задача запускает /review в свежей сессии. Она проверяет код, безопасность, производительность и тесты. Если находит проблемы, записывает замечания в Markdown и возвращает статус fix.

5. /build подхватывает замечания, исправляет код и снова отправляет его на проверку. Цикл build - review продолжается, пока все проверки не пройдены.

6. После успешной проверки Hermes присылает в Telegram краткое описание изменений, результаты тестов и ссылку на PR. Остаётся проверить результат и ответить merge.

Вся память цикла хранится в обычных Markdown-файлах, а фоновые запуски выполняют cron-задачи Hermes.

Утром присылаете несколько идей, днём агент самостоятельно прогоняет разработку и проверки, вечером вы просматриваете готовые изменения. (В идеальном мире)

Собственно можете прислать этот пост своему агенту и попросить выстроить loop.

Чат | Токены дешево
  • 👍 6
Post #158 759
Сатья Наделла, CEO Microsoft, сформулировал тревожный парадокс корпоративного ИИ: компании платят моделям деньгами, а затем передают им свои самые ценные знания через запросы.
Он объясняет, почему собственные данные, память, проверки и loop обучения скоро станут одним из главных активов бизнеса.

📎 Обратный информационный парадокс: кому принадлежит обучение компании

Чат | Токены дешево
Telegraph Обратный информационный парадокс: кому принадлежит обучение компании В эпоху ИИ компания платит за интеллект дважды. Первый раз - деньгами за доступ к модели. Второй - знаниями, без которых модель не сможет стать действительно полезной: внутренними правилами, исправлениями, примерами хорошего результата, рабочими процессами…
  • 👍 3
  • ❤ 1
Post #157 1.22K
Один большой дизайн skill уже не даёт лучший результат: сравнение пяти популярных skills показывает, что UI лучше собирать отдельными проходами. Taste Skill и DESIGN.md мы уже обсуждали, поэтому вот продолжение стека.

По установкам через skills.sh сейчас впереди frontend-design 161к⭐ от Anthropic с 657к, web-design-guidelines от Vercel с 459к, UI UX Pro Max с 263к, Impeccable с 192к и основной skill Эмиля Ковальски со 133к. Но популярность не означает, что один из них стоит держать включённым на всех этапах.

🔵 Impeccable 46к⭐ добавляет 23 точечные команды: /audit, /critique, /polish, /typeset и другие. Внутри есть 46 детерминированных проверок, поэтому его лучше запускать как отдельный проход после первого варианта.

🔵 web-design-guidelines 29к⭐ не придумывает стиль, а проверяет готовую страницу: доступность, формы, состояния фокуса, семантику, адаптивность и анимации. В сравнении пяти skills этот набор оказался сильнее остальных именно по веб-нормам и доступности.

🔵 Emil Kowalski Skills 11к⭐ закрывает движение. /review-animations и /improve-animations исправляют кривые ускорения, появление элементов, жесты и анимации компоновки. Иот же тест поставил этот набор первым по анимациям.

🔵 UI UX Pro Max 105к⭐ полезен на этапе выбора системы: 67 стилей, 161 палитра и 57 пар шрифтов. Большая база правил может ограничивать модель и усреднять результат, поэтому лучше использовать её для направления, а финальную проверку отдать более узким skills.

🔵 shadcn/improve 8к⭐ связывает эти этапы: находит 3-5 самых заметных проблем в кодовой базе и строит план улучшений.

Рабочий цикл:
референс или DESIGN.md → Taste либо Impeccable → /improve → Vercel audit → Emil animations → проверка скриншотом в браузере

Не подключайте все skills для дизайна одновременно. Запускайте их отдельными проходами, тогда правила не спорят друг с другом и видно, какой слой реально улучшил результат.

Чат | Токены дешево
  • 👌 2
Post #156 1.07K
Разработчики Codex поддержали CLIProxyAPI: GPT-5.6 Sol можно запускать прямо в Claude Code

Theo показал Claude Code, где вместо Claude работает GPT-5.6 Sol. Tibo из команды OpenAI попросил выложить рецепт: «мы не дискриминируем обвязки», а затем сам опубликовал настройку через CLIProxyAPI с 40.7к ⭐.

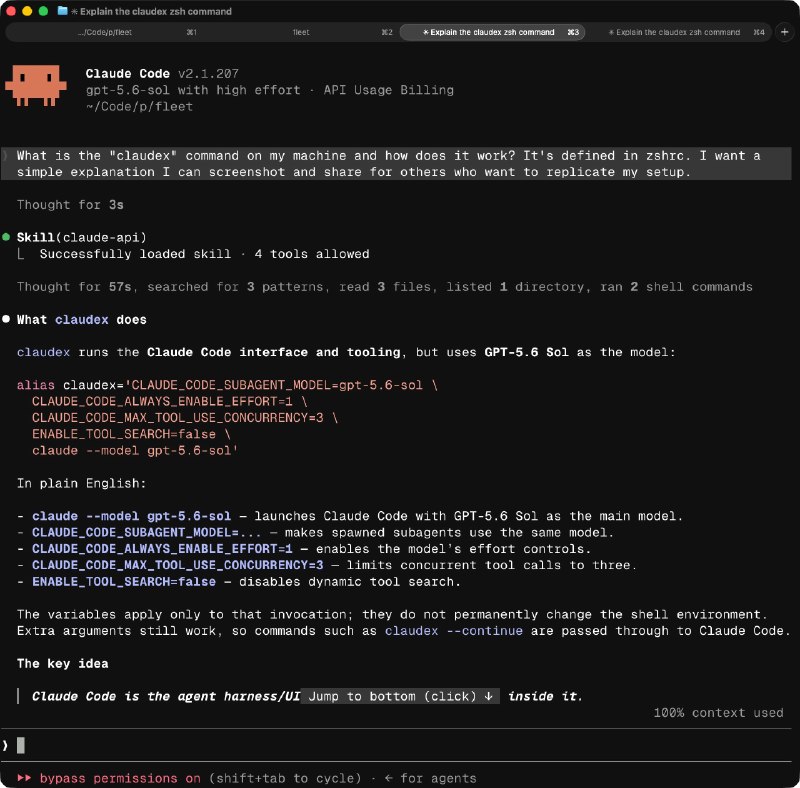
Получается Claudex: интерфейс, инструменты, permissions и субагенты Claude Code, а модель и лимиты приходят через Codex OAuth.

Шаг 1: Установите CLIProxyAPI
Шаг 2: Подключитесь
Шаг 3: Определите следующий alias и наслаждайтесь Claudex:
alias claudex='CLAUDE_CODE_SUBAGENT_MODEL=gpt-5.6-sol \
CLAUDE_CODE_ALWAYS_ENABLE_EFFORT=1 \
CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY=3 \
ENABLE_TOOL_SEARCH=false \
claude --model gpt-5.6-sol'


У этой схемы есть практический смысл. Сейчас в Codex подагенты Sol наследуют уровень effort родителя: запустили основного агента на ultra - все дочерние агенты тоже начинают жечь лимиты на ultra. Проблема все еще открыта, а разработчик Codex DX ответил, что команда уже работает над исправлением. Theo пока советует полностью избегать ultra.

В Claude Code основной Sol можно оставить на xhigh, а подагентам давать medium. В одном небольшом тесте на трех задачах Sol medium в Claude Code оказался примерно на 46% быстрее и использовал на 23% меньше выходных токенов, чем в Codex, при сопоставимом результате. Выборка маленькая, но влияние обвязки на одну и ту же модель видно хорошо.

Чат | Токены дешево
  • 👍 4
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →