TGViewer
Channel Public Channel
Adept | Машинное обучение | Открытое ПО

Adept | Машинное обучение | Открытое ПО

@adept_platform

Меня зовут Кирилл Колодяжный этом канале я буду рассказывать про разработку открытой платформы машинного обучения Adept.
https://adept-platform.gitverse.site/adept-docs/
Subscribers
136
Photos
15
Videos
0
Links
34

Showing posts older than #32 · Back to latest

Older Posts 20 shown
Post #31 289
Post #30 266
Привет, рад сообщить что для проекта начали появляться дополнительные внешние инструменты, знакомьтесь:

SBcontrol - HTTP API + веб-дашборд для удалённого управления фреймворком Adept на Windows с GPU-ускорением через Vulkan.
https://gitverse.ru/Sohoroom/SBcontrol
gitverse.ru Sohoroom/SBcontrol: Training & Inference API for Adept NN Framework — HTTP API + web dashboard for remote training management with… Sohoroom/SBcontrol: Training & Inference API for Adept NN Framework — HTTP API + web dashboard for remote training management with Vulkan GPU acceleration. Up-to-date files and descriptions. Branches and discussions on the developer platform GitVerse.
  • 🔥 4
Post #29 298
Привет, на Хабре вышла моя статья про C++ в ML. По сути там описаны базовые архитектурные подходы используемые в проекте. Будет ещё одна часть.
https://habr.com/ru/companies/yadro/articles/994326/
  • 🔥 5
  • ❤ 3
Post #28 260
Привет, сделал декомпозицию задач про ускорение свёрточных операций — сердце современных CNN:

• https://gitverse.ru/kolkir/adept/tasktracker/TSKDPT3-90
• https://gitverse.ru/kolkir/adept/tasktracker/TSKDPT3-79

Есть три основных задачи:

🔥 Быстрые свёртки для инференса (CPU/GPU)
Цель: Максимально ускорить вывод моделей за счёт оптимизированных алгоритмов свёрток.
Что делать:
Исследовать подходы (включая Winograd и альтернативы)
Учесть ограничения: поддержка batch, channels, padding
Реализовать ядра:
• CPU — через SIMD-библиотеку Highway
• GPU — через compute-шейдеры Vulkan
Сравнить результат с текущим im2col
💡 Идеально, если хочешь разобраться в алгоритмах свёрток и хочешь «выжать» максимум из железа.

⚙️ Умная диспетчеризация режимов
Цель: Автоматически выбирать алгоритм в зависимости от сценария.
Логика:
Инференс: быстрые свёртки для ядер 3×3–7×7 → иначе im2col
Тренировка: всегда im2col (работа с большими матрицами)
🎥 Как устроена наша диспетчеризация

🚀 Implicit GEMM для тренировки
Цель: Ускорить обучение за счёт сокращения аллокаций памяти.
Почему это круто:
Минимум промежуточных буферов
Эффективный тайлинг — строим только нужный фрагмент матрицы свёртки «на лету»
Лучшее распараллеливание → выше производительность на тренировке
Этапы: дизайн → реализация (CPU/GPU) → бенчмарки против im2col → замена при профите.

👉 Готов браться? Читай правила участия, пиши— обсудим детали и подберём задачу под твои скиллы!

#opensource #machinelearning #optimization #vulkan #simd #cpp
  • 🔥 2
Post #27 194

Forwarded from Научный опенсорс (Nikolay Nikitin)

А тем временем, начинаем публикацию программы нашего митапа, который пройдет 12.02 в 18-00. Вот перечень докладов с авторскими аннотациями:

- Школа-конкурс EDGE AI 2025: как мы первыми в России представили флагманский китайский стек для работы с ИИ-моделями на EDGE устройствах c OpenScaler OS // Владимир Павлов - Технический комитет сообщества OpenScaler

В докладе мы поделимся опытом сообщества OpenScaler по проведению соревнований в новом формате: студенческие ИИ-команды из ведущих вузов страны сначала проходили обучение у наших менторов, а затем соревновались на лучшую реализацию различных ИИ-моделей на краевых устройствах Orange Pi на базе чипов Ascend и ОС OpenScaler. Расскажем о самом конкурсе, командах и проектах студентов, которые были представлены в финале. Все учебные материалы были опубликованы в открытом доступе, а проекты финалистов размещены на платформе GitVerse.

- [Секретный доклад] // Олег Чирухин - владелец продукта GigaIDE Cloud

Как понятно из названия - подробности будут раскрыты только в самый последний момент!


- OpenSource по-пекински, или почему фонд OpenAtom - это прекрасно, но не в наших реалиях // Аристов Константин - Скала^р (группа Рубитех), руководитель направления RnD системного ПО

Поговорим о том, какой дивный симбиоз между собором и базаром (openSource и Кговавым Ынтырпрайзом) получился в КНР, попробуем прикинуть тамошние реалии на наши, придем к парадоксальному выводу насчет пользы конкуренции.

- Студенческий open-source в ML - опыт внедрения поддержки ONNX // Зверев Андрей - студент 3 курса Новосибирского Государственного Университета, стажер-разработчик в Яндексе

Как превратить скучную учебную практику в реальный проект, которым не стыдно гордиться и который добавляет ценности в резюме? Расскажу на личном примере участия в лаборатории YADRO при НГУ.
Поясню, что такое формат лаборатории: как туда попасть, какие возможности она дает студентам. На практическом кейсе покажу, как выглядят рабочие процессы изнутри: постановка задач, планирование, работа через issues/PR, тестирование и выпуск; с какими трудностями столкнулся и как их решал при поддержке наставников из реальной компании-партнера.
В технической части объясню простыми словами: что такое ONNX и почему стандарт обмена моделями важен для переносимости и воспроизводимости, чем его поддержка усилила проект Adept и какие результаты получились на практике.


- Simple Deep Research - открытый фреймворк для мультиагентного поиска // Алан Газзаев - аспирант ИТМО, NLP researcher at MWS AI

Simple Deep Research - это простая система для поиска информации в интернете с помощью мультиагентного подхода. Система работает в двух режимах: lite и full. В первом режиме агент посещает несколько сайтов, сжимает информацию и выдает отчет. Во втором режиме агент определяет сложность запроса, разбивает его на подзапросы, а затем другие агенты ищут и суммируют информацию по каждому запросу. Одна из основных идей данного фреймворка заключается в том, что он не содержит таких зависимостей как langchain и smolagents и быстро запускается с локальными моделями через vLLM/llama.cpp. Также фреймворк модульный, можно заменить поисковой движок и агентов по необходимости.

Ссылка на регистрацию прежняя - https://openmeetup.ru/
Места на площадке конечны, так что не откладывайте!
Post #26 162
Привет, приходите на Scientific Open Source meetup.
Про опыт участия в нашем проекте расскажет Андрей Зверев студент 3го курса НГУ.
Post #25 232
Привет, в работе над проектом постоянно сменяются периоды активной разработки и этапы отладки, тестирования и оптимизации.

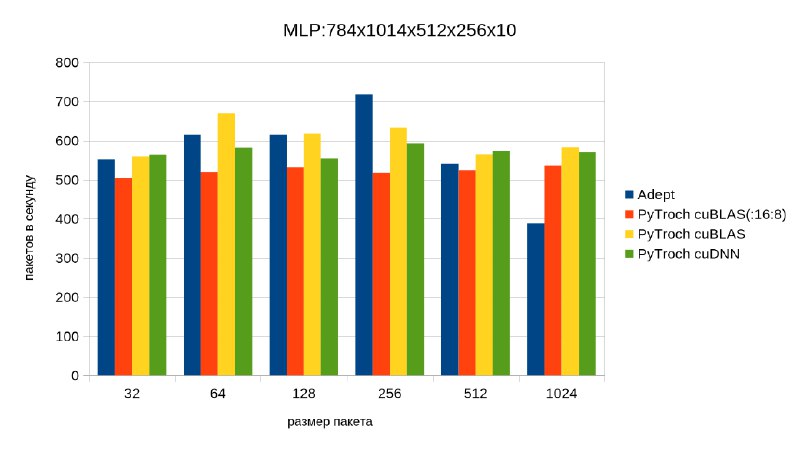
На прошлой неделе основное внимание было уделено тестированию и доработке ядра матричного умножения (matmul). Благодаря увеличению нагрузки на потоки и изменению размера тайла удалось добиться заметного ускорения на средних размерах — это подтверждается графиком сравнения Adept и PyTorch с разными режимами использования cuBLAS .

Однако начиная с размеров 512×1024 производительность Adept начинает значительно отставать, см. график. А это критично: особенно в современных LLM. Например, в модели Qwen-7B, которую можно запускать локально, типичные операции включают умножения вида:
- 4096 × 4096 (линейные слои),
- 4096 × 11008 (expansion в MLP блоках).

Теперь надо определиться что же делать дальше. Есть несколько важных направлений:

1. Продолжать оптимизировать matmul.
Например внедрить транспонирование одной из входных матриц (обычно B). Это позволит:
- организовать сгруппированный доступ к данным (все потоки в warp’е читают соседние адреса),
- использовать прямоугольные тайлы (например, 64×128),
- лучше распределить работу между потоками и повысить occupancy.
Да, такой подход требует дополнительной памяти для хранения транспонированной матрицы — но это стандартная практика: даже cuBLAS выделяет рабочую память, управляемую через параметры worksize.

2. Оптимизация операций свёртки, которые критичны для CNN и гибридных архитектур. Тут надо реализовать быстрые свёртки с использованием алгоритма Winograd. Алгоритм Implicit GEMM для работы в стиле im2col но без промежуточных матриц.

3. Также крайне важно завершить реализацию функциональности срезов тензоров — без неё невозможно поддерживать широкий спектр моделей машинного обучения, включая те, что используют динамические формы или сложные attention-маски.

🚀 Приглашаем всех заинтересованных принять участие в развитии Adept!
Ваш вклад — будь то тестирование, код, идеи по оптимизации или документация — напрямую ускорит появление полноценного Vulkan-бэкенда для ML.

#Adept #Vulkan #GPU #GEMM #LLM #TensorSlicing
Telegram adept Сравнение производительности matmul в Adept и PyTorch: количество пакетов в секунду при тренировке. Обратите внимание что производительность PyTorch c отключенным и включенным cuDNN практически одинаковая - так как используются только линейные слои т.е.…
  • 👍 2
  • 🔥 2
  • 👌 1
Post #24 168
Сравнение производительности matmul в Adept и PyTorch: количество пакетов в секунду при тренировке.

Обратите внимание что производительность PyTorch c отключенным и включенным cuDNN практически одинаковая - так как используются только линейные слои т.е. matmul.
  • 👍 3
Post #23 190
Привет! Небольшой анонс: я буду делать доклад про реализацию конвейера для запуска вычислительных шейдеров в Adept на конференции С++ Russia 2026 которая будет проходить 16-17 мая в Москве, приходите послушать.
https://cppconf.ru/talks/823852ac77f1480c8276b17b1736bb5f/
C++ Russia 2026. Конференция по C++ и системному программированию Эффективный запуск compute-шейдеров в Adept | Доклад на C++ Russia 2026 Поделюсь опытом создания эффективной среды выполнения compute-шейдеров в рамках open-source проекта Adept.
  • 🔥 6
Post #22 907
🔍 Как стабилизировать систему перед нагрузочным тестированием

Если вы сравниваете производительность (например, как я наш Vulkan-бэкенд vs PyTorch), важно обеспечить воспроизводимость бенчмарков, исключив влияние системных факторов. Например динамическое управление частотами или рандомизации памяти. Вот минимальный набор команд для Linux-систем с NVIDIA GPU с которых можно начать:

🖥️ GPU (NVIDIA)
# Включить persistence mode (чтобы драйвер не «усыплял» GPU)
sudo nvidia-smi --persistence-mode=1

# Зафиксировать частоты (пример для RTX 4070)
sudo nvidia-smi --lock-gpu-clocks=3105 # MHz (core)
sudo nvidia-smi --lock-memory-clocks=8001 # MHz (VRAM)


> ⚠️ Значения частот подбирайте под вашу модель GPU. Их можно найти в выводе nvidia-smi -q -d SUPPORTED_CLOCKS.

⚙️ CPU
# Переключиться в режим максимальной производительности
sudo cpupower frequency-set -g performance

# Зафиксировать минимальную частоту (например, 3.9 ГГц)
sudo cpupower frequency-set -d 3900000


> Это позволяет задать более-менее предсказуемый диапазон частот для процессора.

🧠 Дополнительно: уменьшаем системный «шум»
# Отключить ASLR (Address Space Layout Randomization)
echo 0 | sudo tee /proc/sys/kernel/randomize_va_space


>Это повышает воспроизводимость времени запуска и распределения памяти — особенно важно при микро-бенчмарках.

💡 Другие рекомендации:
- Закройте фоновые приложения
- Отключите энергосбережение в BIOS/UEFI (C-states, P-states)
- Запускайте тесты несколько раз и берите медиану
- Используйте taskset или numactl, чтобы изолировать ядра CPU
- Для серверных GPU: отключите коррекцию ошибок ECC (`nvidia-smi -e 0`), если это не критично.

Такой подход позволяет добиться воспроизводимых результатов — без него сравнение «на глаз» может ввести в заблуждение.

P.S. Эти настройки временные — после перезагрузки всё вернётся к стандартному поведению. ⚠️ Не применяйте их на продакшен-машинах без понимания последствий!

#GPU #Benchmarking #Vulkan #PyTorch #ML #Linux #Performance #Adept
  • 👍 2
Post #21 279
🛠️ На каких Linux-дистрибутивах проверена сборка Adept

Проект успешно собирается и запускается на следующих системах:

🔹 Manjaro Linux 26.0.1 — основная платформа разработки
🔹 Ubuntu 22.04
🔹 Ubuntu 25.10 (development release)

А также на отечественных дистрибутивах:
🔹 Astra Linux Smolensk 1.8.3
🔹 ALT Linux StarterKit 11 «Slavia»

Особенности:

- В ALT Linux по умолчанию включён _FORTIFY_SOURCE в GCC, что мешает сборке oneTBB. Обход описан в Wiki проекта.
- Сборка под Astra Linux была протестирована участником канала — отдельное спасибо! Использовался GCC 12.2.
⚠️ В этом компиляторе есть ложные срабатывания -Warray-bounds при сборке в отладочном режиме, из-за чего сборка может не завершиться. В режиме Release проблем не возникает.

Мы продолжаем расширять список поддерживаемых платформ и документировать нюансы сборки — ваш опыт тоже важен!

#Linux #GCC #AstraLinux #ALT #Build #Cplusplus
  • ❤‍🔥 1
Post #20
Adept | Машинное обучение | Открытое ПО pinned «Привет, немного информации о проекте про разработку которого я рассказываю в этом канале: Adept(Automatic Differentiation Engine for Tensor Processing) — это библиотека на Python и C++ для построения и обучения нейросетей, созданная с упором на кроссплатформенность…»
Post #19 6.65K
Привет, немного информации о проекте про разработку которого я рассказываю в этом канале:

Adept(Automatic Differentiation Engine for Tensor Processing) — это библиотека на Python и C++ для построения и обучения нейросетей, созданная с упором на кроссплатформенность, гибкость и образовательную ценность.

⚙️ Основные возможности:
• Динамические графы — как в PyTorch: отладка, условия, циклы «из коробки».
• Тензоры + Autograd — автоматическое дифференцирование и GPU-ускорение.
• Vulkan backend — работает на GPU от NVIDIA, AMD, Intel, Qualcomm и даже на мобильных устройствах.
• Единая семантика Python/C++ — легко переносить прототип в production.

🎯 Зачем это нужно?
В российской экосистеме почти нет open-source ML-платформ общего назначения, сравнимых с PyTorch или TensorFlow. Возможно это связано как с нехваткой специалистов, сочетающих глубокое понимание машинного обучения и системного программирования, так и доступностью зрелых альтернатив. Adept создан как экспериментальная площадка для накопления такого опыта — как исследовательского, так и образовательного.

🧠 Почему это полезно для обучения?
Проект охватывает все ключевые уровни ML-стека: от математических абстракций (тензоры, градиенты) до низкоуровневой работы с GPU. Это делает его подходящей основой для:
• Изучения архитектуры современных ML-фреймворков
• Курсовых, дипломных и исследовательских работ
• Практических заданий по deep learning, системному программированию и кроссплатформенной разработке

🔗 Код открыт — приглашаем студентов, преподавателей, энтузиастов и всех, кто хочет разобраться, как устроены ML-платформы изнутри.

#MachineLearning #OpenSource #Education #Vulkan #Python #Cpp #Adept #MLPlatform
  • 👍 7
  • 🔥 2
Post #18 294
🎄 Новогодние каникулы прошли не только в кругу семьи и друзей, но и за кодом! Завершил рефакторинг системы управления ресурсами Vulkan-конвейера в нашем проекте.

Что изменилось:
✅ Убрал необходимость ручной синхронизации в конце обработки пакета при обучении моделей
✅ Снизил нагрузку на аллокаторы ресурсов
✅ Сделал управление ресурсами более предсказуемым и «плавным»

Провёл сравнительное нагрузочное тестирование — и результаты радуют:
📈 На задачах с LeNet и ResNet50 (CIFAR10/MNIST, FP32, Adam) производительность Adept теперь сопоставима с PyTorch, особенно в режимах с ограниченным worksize и детерминированными алгоритмами cuBLAS. Это означает, что для типичных свёрточных сетей, т.е. небольших размерностей матричного умножения, мы почти «на равных».
✨ При этом размер батча больше не оказывает заметного влияния на производительность конвейера, что раньше было одной из проблем.

Но есть и над чем работать:
⚠️ В тестах с MLP (только матричное умножение, большие размеры) производительность начинает падать уже при размере матриц 128×128. Это связано с текущей реализацией GEMM-ядра — сейчас она соответствует субоптимальному варианту алгоритма, который я и показывал в статье на Хабре. Т.е. результат вполне объяснимый.

Следующий шаг — переписать ядро matmul, чтобы интенсивнее использовать регистры и минимизировать обращения к локальной памяти, что позволит приблизиться к производительности cuBLAS даже на крупных матрицах.

Подробные результаты измерений — в вики проекта.

GPU-оптимизация — это марафон, а не спринт 😊

#Vulkan #GPU #GEMM #C++ #PyTorch
  • 🔥 4
  • 👍 2
Post #17 251
🎄 С наступающим Новым годом!

Спасибо всем подписчикам, за ваш интерес, вопросы, идеи и вклад в развитие нашего открытого проекта. Ваша поддержка — лучшая мотивация для движения вперёд.
Пусть в наступающем году сбудутся все ваши профессиональные и личные планы, а в коде будет меньше багов и больше интересных решений! Желаем вам сил на новые свершения, вдохновения для смелых экспериментов и времени на любимые проекты.
Отдыхайте, набирайтесь сил и ярких впечатлений!

До встречи в новом году! 🥂
  • ❤ 4
  • 🎉 2
Post #16 266
Привет! Столкнулся с интересной ситуацией, которая хорошо иллюстрирует важность внимательного чтения документации.

❌ Проблемный код
У меня был std::list<std::unique_ptr<Item>>, и я хотел переместить завершённые элементы в другой список. Написал, казалось бы, логичный код:

auto it =  std::remove_if(active.begin(), active.end(), [](auto& item) {
if (item->is_completed()) {
item->reset();
return true;
}
return false;
});

// Перенос в другой список
stopped_submits_.splice(stopped.begin(), active, it, active.end());


И... неожиданно обнаружил нулевые указатели в списке!

🔍 Что пошло не так?

Ошибка №1: Нарушение контракта предиката
Сигнатура std::remove_if требует, чтобы предикат не модифицировал элементы:
template< class ForwardIt, class UnaryPred >
ForwardIt remove_if(ForwardIt first, ForwardIt last, UnaryPred p );

Из документации:
>The expression p(v) must be convertible to bool for every argument v of type (possibly const) VT, where VT is the value type of ForwardIt, regardless of value category, and must not modify v.

Мой item.reset() явно нарушает это требование.

Ошибка №2: Неопределённое состояние после remove_if
После работы std::remove_if элементы в диапазоне [result, last) могут находятся в неопределённом состоянии. Для std::unique_ptr это означает, что они могут стать нулевыми в результате перемещения!

Из документации:
> Each element of [result, last) has a valid but unspecified state, because move assignment can eliminate elements by moving from elements that were originally in that range.

📚 Выводы
1. Используйте std::remove/remove_if в рамках идиомы remove-erase
3. Читайте документацию и стандарт, в частности cppreference

#cpp #stl #cplusplus #bugs
  • 🔥 5
Post #15 203
Привет!

Мы активно работаем проекта и хотим поделиться нашими ближайшими планами и текущими работами. Многие из этих улучшений станут возможны благодаря вкладу студентов-разработчиков!

Что в разработке:

1. Умное управление ресурсами Vulkan 🔧

- Проблема: Сейчас ресурсы (буферы, наборы дескрипторов) накапливаются, и для их очистки требуется принудительная синхронизация с хост-системой, что тормозит выполнение.

- Решение: Мы работаем над усовершенствованием системы, чтобы ресурсы освобождались пакетами и по мере накопления, минимизируя простои и повышая эффективность.

2. Импорт моделей ONNX 📥

- В мастер скоро будет залит минимально рабочий прототип для импорта моделей в формате ONNX!

- Эта важная функциональность была реализована студентом НГУ в рамках практической работы в лаборатории ФИТ. Большое спасибо за этот вклад!

- Дальше мы планируем развивать и расширять эту возможность.

3. Распределённое обучение (Data Parallelism) ⚙️

- Ведутся работы по реализации распределённого обучения с параллелизацией по данным. Это позволит значительно ускорить обучение больших моделей на нескольких GPU.

4. Большая эволюция вычислительного графа 🧠

- Запланирована серьёзная переработка архитектуры вычислительного графа.

- Цель: сделать граф максимально гибким для проведения сложных оптимизаций, а также для конвертации в другие промежуточные представления, такие как ONNX или различные диалекты MLIR. Это откроет путь к интеграции с другими экосистемами и инструментами.

Важно отметить: Работы по пунктам 3 и 4 (распределённое обучение и новая архитектура графа) также ведутся в рамках студенческих проектов и практик. Мы рады поддерживать новое поколение инженеров и исследователей!

Следите за обновлениями в репозитории, и, как всегда, ждём ваших вопросов, идей и участия!

Ссылка на репозиторий: https://gitverse.ru/kolkir/adept

#Adept #MachineLearning #OpenSource #Vulkan #ONNX #DistributedTraining #MLIR #Разработка #НГУ #Студенты
  • 🔥 1
Post #14 204
Вышел релиз v0.1.3

В котором добавлено:
- Поддержка Float64, Int32 and Int8 типов данных.
- Поддержка различных Vulkan устройств (проверено на NVIDIA RTX 4070 8Gb, Adreno (TM) 650, Intel(R) Graphics (RPL-S)).
- Использование Float64 для аккумуляторов на устройствах которые поддерживают этот тип.
- Изменение системы кэша подсистемы Vulkan с учётом статических параметров шейдера.
- Глубокая переработка конвейера запуска шейдеров Vulkan для устранения конфликтов синхронизации.
- Исправление множества ошибок.

https://gitverse.ru/kolkir/adept/releases/tag/v0.1.3

#release
  • 🔥 2
Post #13 187
Привет, я снова с проблемой: собрал Python-пакет, зависящий от нативных библиотек (C/C++), а на другой системе он отказывается работать? «glibc не той версии!» — кому-то знакомо?

Оказывается есть проект manylinux от PyPA (Python Packaging Authority) который создан именно для решения головоломки 🧩 с подбором относительно универсальных системных библиотек.

Проект предоставляет набор Docker-образов на основе старых, но широко распространённых версий glibc, других системных библиотек, компиляторов и средств для сборки. Пакет собранный внутри manylinux-контейнера, практически гарантированно будет работать на большинстве современных Linux-дистрибутивов.

Вот пример как создать рабочее окружение:
docker pull quay.io/pypa/manylinux_2_34
docker run -v /development/gitverse/adept:/adept -it quay.io/pypa/manylinux_2_34 /bin/bash
...
python3.11 -m build

Теперь CPU версию Adept можно использовать в Google Collab, вот ссылка на небольшой пример: тренировки LeNet для распознавания MNIST.

#python #packaging #docker #linux #pypi
  • 👍 1
Post #12 214
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →