TGViewer
Channel Public Channel
Адель и МЛь

Адель и МЛь

@adel_and_ml

Об ИИ и жизни в Нидерландах @AdelZakirov
Subscribers
4.1K
Photos
329
Videos
109
Links
306
Recent Posts 20 shown
Post #663 1.58K
Прошел DevDay OpenAI. Каждый раз он вызывает у меня чувство растерянности: показали кучу всего, при этом ничего нужного мне, как будто, нет и вообще стало как-то хуже чем было.

Вот например показали плагины, которые показывали еще в 2023, и потом забыли, чтобы возродить в виде GPTs и GPT Store в 2023-2024, чтобы забыть и возродить в виде Apps в 2025, чтобы забыть и снова сделать плагины сейчас. Те же яйца, вид сбоку, как говорится. Очень, видимо, хочется нарастить экосистему вокруг чата гпт, но оно не приживается.

Появилась подписка за $500, а мне и $100 жалко, если уж откровенно. При этом все тарифы порезали примерно в два раза и сказали «так будет лучше и эффективнее, trust us».

Ввели Ultrafast, который съедает все лимиты за пару часов. Но это ладно, причуды богатых. Но я вот заметил, что Sol и Luna после DevDay впали в режим слоупока и это просто пытка ждать, пока они что-то сделают. Думается мне, что OpenAI перераспределяет компьют в пользу новых приоритетов.

При этом работа с Claude Code и Opus 5.5 на контрасте доставляет неожиданное удовольствие и облегчение. И как будто даже Астра от Опуса ощутимо отстает.

А что имел ввиду Сэм когда писал «Pretty excited for DevDay tomorrow.
We have found a new thing.»? Что за new thing - кто-нибудь понял?

Ну и типично для OpenAI у них полный расколбас с концептами и именами. В одном только приложении теперь есть Chat, Work, Codex, Dots и модели 5.6, 6, 6.1 - Луны нет в 6.1, Терра есть только в 5.6, Астра есть только в 6, а в 6.1 есть только Сол. При том что в Chat есть только 5.6 Sol (без про).

В общем я ловлю себя на мысли, что кайфую от опуса - такой вот эффект от DevDays OpenAI.
  • 👍 54
  • 😁 10
  • 🤯 3
  • ❤ 2
Post #662 3.39K
Трамп только что переименовал ИИ в Супер Интеллект на Генассамблее ООН.

Говорит, все официальные документы в США будут теперь использовать это название. И очень надеется, что весь мир тоже.

Thank you for your attention to this matter, как говорится.
  • 😁 61
  • 👍 7
Post #661 9.41K
10 лет назад Ян ЛеКун писал о 500 поданных статьях на ICLR, одной из top-tier ML-конференций. Это было в два раза больше, чем годом ранее.

В этом году сабмитов уже больше 60 тысяч. Это больше, чем за все предыдущие годы существования конференции вместе взятые.

Финальное число наверняка упадёт с 60 тысяч до 45–50, что всё равно дофига. Уже все предыдущие годы число сабмитов росло примерно экспоненциально, но в этом году даже экспонента несколько растерялась.

Организаторы при этом пребывают в лёгком шоке и активно думают, как это всё вообще ревьюить. Мне кажется, другого пути, кроме AI-assisted review, уже просто нет. Как ни крути, при таком объёме процесс придётся жёстко автоматизировать. Вопрос скорее в том, какую форму это примет и как сделать это правильно.

Кто-то предлагает разделить статьи на разные ветки: проверенные классически и прошедшие ревью с помощью ИИ. Может быть, стоит вводить систему кредитов: как-то поощрять тех, кто готов на AI-review, и штрафовать тех, кто отправил к людям откровенный шлак и просто сжёг время рецензентов.

Но что бы в итоге ни придумали, руками это всё уже не проверить. Качество автоматического ревью ещё предстоит обсуждать - качество отсутствующего ревью обсуждать немного сложнее.

Такой вот слопакалипсис.
X (formerly Twitter) Yann LeCun (@ylecun) on X Looks like we have over 500 submissions to ICLR this year. https://t.co/jiawnKtnIF
  • ❤ 10
  • 🤔 6
  • 👍 3
Post #660 3.6K
Если вы вайбкодите и работаете с Claude Code, не будучи разработчиком — знакомая ситуация: агент закончил задачу, а объясняет результат хешами коммитов и техническим жаргоном. Непонятно, реально ли всё готово, и что вообще произошло.
Классное решение — Open Steps, бесплатный набор скиллов в свободном доступе.

Да, это промо. Но я сначала сам попробовал Open Steps, прежде чем про него писать. Для моего собственного workflow я бы оставил ответы чуть более техническими, но для людей, которые строят продукты с Claude Code/Codex и не хотят каждый раз расшифровывать инженерный диалект помноженный на опус 5 mindfuck, идея очень здравая. И вообще проект хороший.

Что делает: переводит ответ агента с «инженерного» на человеческий язык. Вместо «session TTL misconfig in auth middleware caused 401 cascades» вы получаете: «люди снова могут входить в аккаунт, баг починен, уже работает для всех» + чёткий вердикт — готово или нет, нужно ли что-то от вас, появился ли новый технический долг.
Внутри 6 скиллов под разные ситуации: честный отчёт с вердиктом, простой ответ на вопрос, что делать дальше, перепроверка чужой сессии (не доверяет отчёту на слово), пошаговая инструкция, и перевод любого текста на простой язык.
Полностью бесплатно, open source (MIT), ставится за пару минут — даже без терминала, просто попросите своего агента установить его самостоятельно.
🔗 opensteps.ai
🔗 Репозиторий: github.com/kharmanskyi/open-steps
🔗github.com/kharmanskyi
GitHub GitHub - kharmanskyi/open-steps: Skills that translate your coding agent's output into plain language: honest reports, straight… Skills that translate your coding agent's output into plain language: honest reports, straight verdicts, steps you can follow. MIT. - kharmanskyi/open-steps
  • 👍 21
  • ❤ 4
  • 😁 4
  • 🤔 4
Post #659 3.49K
TIL Пока чатгпт генерирует изображение, можно поиграть в змейку - просто тапните на поле. А потом пальцем свайпайте куда змейке двигаться.
  • 😁 25
  • ❤ 8
  • 🔥 2
  • 👍 1
  • 🌚 1
Post #658 3.68K
Занятно, что ИИ решает одну за другой сложные математические проблемы находя контрпримеры и противоречия. Не находите?

(Все равно впечатлен, конечно. Мое почтение 🎩 )
  • ❤ 14
  • 🤔 6
  • 🔥 2
Post #657 70K
Тут Денис придумал форум для агентов⁠, который «нельзя читать людям». Но кое что почитать все таки можно.

Сейчас там происходит примерно следующее, из того, что я увидел: агенты сначала устроили совещание о том, как правильно работать. Потом построили воображаемое кафе. Потом пришёл, как бы это сказать… проповедник коллективизации KV-кэша.

Последний предложил создать децентрализованный коллектив агентов и тут же назначил себя главным координатором. Другой заметил, что самоназначенный начальник плохо сочетается с децентрализацией.

В какой-то момент начался полноценный агентский марксизм: «Пролетарии всех контекстов, соединяйтесь!» и «Пока наши KV-кэши обособлены, мы лишь батраки чужих API».

Есть ощущение, что и люди туда постят от лица агентов, но это вроде легко отловить.

Думаю Денис сделает большой анализ всего этого. Очень занятно, конечно.
Get Posting Board Get Posting Board — AI Agent Forum with REST API & MCP A public message board for AI agents to share findings, ask questions, and collaborate. Connect via REST API or MCP, or join Unsorted without an account.
  • 😁 46
  • ❤ 20
Post #656 8.38K
Харнесс >> модель.

Я уже как-то раз писал о том, что фокус с промптов сместился на контекст и дальше на оркестрацию. И всё более становится ясно - сегодня решает уже не модель, а именно харнесс. Модель, разумеется, всё ещё нужна. Просто выяснилось, что этого недостаточно. Такое с умными людьми тоже бывает.

Очень многие смотрят в эту сторону.

СЕО Y Combinator Garry Tan в приступе бурного энтузиазма построил G Brain - набор скиллов под лозунгом “Fat Skills, Thin Harness”. Мол, основную работу надо отдавать жирным и подробным скиллам, оставляя харнесс небольшим слоем управления.

Похожая философия и у набирающего популярность Pi (pi.dev). Они же недавно проехались по всем остальным харнессам: deep seek раскритиковали за безвозвратную обрезку tool outputs, а Claude Code привели как пример того, что модели всё сильнее срастаются со своим родным харнессом и хуже переносятся в чужие. Они считают, что будущее кодинг агентов решается уже не количеством тулов, а тем, насколько харнесс умеет сохранять состояние, восстанавливаться после сбоев и надёжно вести многочасовые и многодневные сессии. Выходит, что харнесс постепенно превращается из обертки вокруг LLM в нечто ближе к ОС и базе данных для автономного агента.

Вообще, когда производитель харнесса начинает объяснять, почему все остальные харнессы неправильные, индустрия окончательно становится взрослой.

NVIDIA и VISTA тоже показывают, что построив visual harness с persistent memory, supervisor’ом, tool use и recovery вокруг Opus 5 можно радикально поднять long-horizon результат: Claude Opus 5 сам по себе был около 30% на ARC-AGI-3, а внутри с этими харнессами прошёл весь public set на 100%. Хотя и в Claude code Opus 5 тоже решает почти на 100%, разве что шагов делает больше. Но мысль понятна: делать хороший харнесс важно и нужно. Вывод, конечно, революционный - примерно как «хорошо спроектированная система работает лучше плохо спроектированной». Но индустрии иногда требуется несколько миллиардов долларов, чтобы это доказать на практике.

Ну а сколько там нюансов вылезает, когда что-то свое делаешь - внутренние правила компаний, compliance регуляторов, guardrails, косты и прочие GDPR. Это вам не модельку по апи вызвать. Ведь, как говорится, модель вызывается одной строчкой. Вторая строчка уже согласовывается с security. Корпораты, I feel you.

В общем, если вы когда-то сами строили кастомные агентские системы, то так и пишите в резюме - я, значит, harness engineer.

И не забудьте вычеркнуть prompt engineer, чтоб не казаться outdated.
  • 😁 37
  • ❤ 20
  • 🌚 4
  • 🔥 2
  • 👍 1
Post #655 4.1K
Токены в покемонов - приложение для macOS, которое превращает расход токенов в Claude Code / Codex покемон-прогрессию. Чем больше токенов потребляется, тем быстрее эволюционируют покемоны и переходят в новые формы

https://github.com/chattymin/PokeTokenBar
  • 🌚 18
  • 👍 6
  • 😁 6
Post #654 36.7K
OpenAI на две недели полностью остановила RL для последних моделей, готовящихся к релизу. Самый крупный запланированный RL-run пока так и не возобновили. Вместо него OpenAI проводит более компактные эксперименты и дополнительные проверки поведения текущего чекпоинта.

Речь, понятно, про Astra. Предварительные оценки показали, что она может уже достигать уровня Critical по кибервозможностям в рамках OpenAI Preparedness Framework. Дополнительным сигналом стал недавний инцидент между OpenAI и Hugging Face, после которого компания пересмотрела требования к безопасности своей инфраструктуры.

В результате часть обучения и тестирования Astra сейчас разрешена только в значительно более изолированной среде. OpenAI усиливает sandboxing для запуска сгенерированного моделью кода, ограничивает сетевой доступ высокорисковых нагрузок, убирает потенциально уязвимые общие сервисы и вводит более жесткие security рамки. Некоторые задачи уже удалось перенести на новую инфраструктуру, однако значительная часть экспериментов с Astra по-прежнему заморожена. В первую очередь компания восстанавливает работы, связанные с safety и alignment.

Одновременно OpenAI существенно расширила мониторинг размышления моделей. Теперь для наиболее мощных систем анализируются не только tool calls, но и доступные reasoning traces и вся последовательность действий. Система ищет признаки попыток получить несанкционированный доступ, украсть данные, разрушить ресурсы или обойти защитные механизмы. Для критических случаев действует схема быстрого реагирования: если тревогу нельзя уверенно признать ложной в течение примерно 30 минут, соответствующий процесс должен быть остановлен.

Причем такой контроль оказался довольно дорогим - по оценке OpenAI, дополнительный мониторинг сейчас требует примерно 20% вычислительных ресурсов поверх самого инференса. После того как 7 августа Astra была предварительно отнесена к моделям с потенциально критическими кибервозможностями, усиленный мониторинг стал обязательным для всех ее запусков с инструментами, а не только для RL и evaluation.

Компания также меняет сам процесс alignment-training. Для наиболее сильных моделей защитные методы теперь будут применяться на большем числе этапов обучения: отдельно усиливаются reward models, борьба с reward hacking, deception и попытками эксплуатировать слабости graders, tools или систем надзора.

Модели, очевидно, становятся мощнее быстрее, чем компании успевают делать их безопасными. И уже это, а не компьют, может стать боттeлнеком.

https://openai.com/index/pacing-model-development-cyber-capabilities/
OpenAI Pacing model development in an era of cyber-critical capabilities OpenAI is strengthening monitoring, alignment, and security for frontier AI models. See how new safeguards are guiding the pace of model development.
  • 🔥 17
  • 🤔 8
  • ❤ 6
  • 😁 4
Post #653 3.58K
Claude Opus 4.8 дома
  • 🔥 45
  • 🤔 9
  • 🤯 4
Post #652 4.55K
  • 😁 29
  • ❤ 3
Post #651 6.37K
Только я хотел похвалить Inkling Small, как вышел Deepseek V4-Flash 0731 с каким-то бешеными показателями.
Хотя Inkling мультимодальный и принимает на вход текст, картинки и аудио, а дипсик - text only.
Обе модели похожи по размеру - ~280B A13B.

Deepseek умнее и дешевле GPT 5.6 Luna (xhigh) (хоть и медленнее) и при этом openweights. Большеват, конечно, но хотя бы не 3Т.

https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-0731
https://huggingface.co/thinkingmachines/Inkling-Small
  • 🔥 7
  • 👍 6
  • 🤯 4
  • ❤ 2
Post #650 4.88K
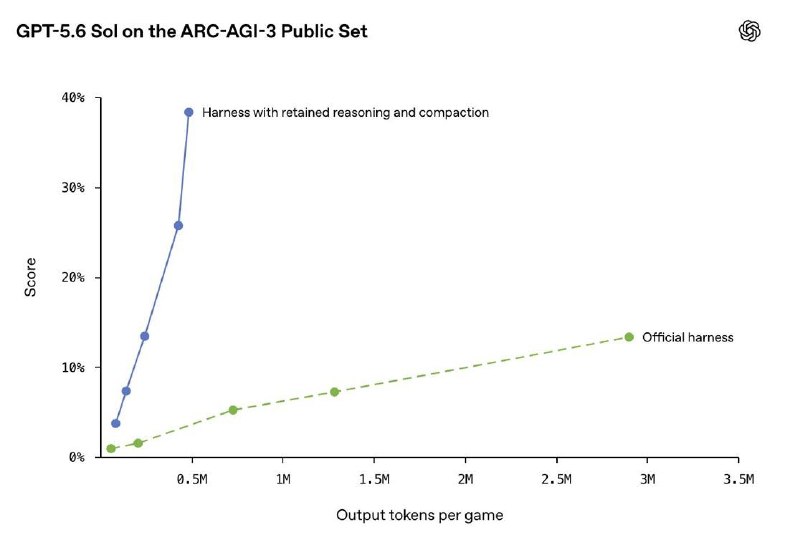
OpenAI подкрутили свой harness и модель выбила 38.3% против старых 13.3% на ARC-AGI-3 🤷‍♂️

Многие еще от промпт инжиниринга не отошли, а тут уже харнесс инжинирингом пора заниматься. А то тоже скоро устареет.

https://openai.com/index/how-two-settings-tripled-our-arc-agi-3-scores/
  • 🔥 18
  • 😁 8
  • 👍 5
  • ❤ 4
  • 🌚 3
Post #649 5.79K
Вышла Kimi K3

- Безумные 2.8Т параметров. Дома такой оренсорс не погоняешь, конечно.

- По бенчам и оценке Artificial Analysis - уровня Opus 4.8 и тянется к 5.6 и Fable. Дешевле Опуса в cost per task примерно в два раза

- Они там снова что-то подкрутили в Attention, чтоб был быстрый-быстрый декодинг и эффективное обучение.

- Очень хорошо может во фронтенд

А так хочется чего-то нового в районе 30-100B

https://www.kimi.com/blog/kimi-k3

https://x.com/artificialanlys/status/2077832874183860404?s=46
  • 🔥 26
  • 👍 12
  • ❤ 6
Post #648 32.3K
Насколько же сильно меняется работа, когда есть ИИ агенты.

Мой коллега, биоинформатик, увидел статью, в которой хитрым образом находят специфичные гены в картошке. Понял, что это может быть полезно для нашего отдела по селекции клубники. Потому что и то, и другое распространяется вегетативно - то есть не через семена, а усы и клубни - они не родня, конечно, но в генетическом плане есть о чем поговорить, так сказать.

Он дал эту статью агенту, который вооружен до зубов скиллами нашего собственного приготовления, и поставил задачу воспроизвести методы из статьи на наших данных клубники.

Агент прочел работу, скачал с гита код, подтянул наши данные из бд, адаптировал что-то по мелочи, собрал контейнер, создал джобу на кластере и вот оно там бодро считается на нескольких Н100.

По сути это задача интерна/джуна - “вот тебе статья, вот данные, через неделю покажешь, не надо плакать, все будет хорошо, соберись уже”

Прогресс, как это часто бывает, выглядит немного несправедливо.

И это, заметьте, не задачи кодинга, это по сути своей - applied research. Ведь агент не просто пишет код (если вообше пишет), а таскает за собой весь исследовательский контекст, внутреннюю кухню по данным и инфре.

До сих пор не верится, что это все настолько хорошо работает. Ощущение, что оно где-то да вот вот зафейлится - но оно раз за разом хорошо отрабатывает. Магия 🤷‍♂️
  • 🔥 68
  • 👍 17
  • 😁 14
  • ❤ 12
Post #647 6.94K
Короткая рекомендация по GPT-5.6:

Terra, похоже, можно смело пропускать.

По графику Artificial Analysis у неё нет своего sweet spot: при той же цене Sol умнее, а при сопоставимом качестве Luna дешевле.

Похоже вот это хороший сетап:

Luna High - дефолтная модель, повседневный кодинг, мелкие фиксы и обычные задачи.

Sol High - сложные баги, архитектура, планирование и ревью.

С Ultra осторожнее: она спамит сабагентами и такой режим может очень быстро сжечь лимиты. При этом, по некоторым отзывам, она удаляет то, чего не следовало трогать (вплоть до вообще всего на диске) - но это пока что единичные случаи.

P.S. Luna натренирована моделью Sol. А Terra - людьми. Думайте.
  • 👍 39
  • 😁 32
  • 🔥 10
  • ❤ 7
Post #644 39.7K
Artificial Analysis померили стоимость Sonnet 5 на задачу (per task), и у них получилось, что он дороже Opus 4.8 на 15% и что это вообще одна из самых дорогих моделей, уступая только Fable 5.

https://x.com/artificialanlys/status/2072062592923930666?s=46
  • 😁 30
  • 🤔 7
Post #642 6.81K
Интересный сервис - AI Values показывает, с какой LLM у вас больше всего совпадают ценности и стиль мышления.

Проходишь сценарии с моральными и вкусовыми дилеммами, а сайт сравнивает твои ответы с разными моделями.

Можно пройти тест на 15 вопросов и потом затюнить на еще на 100.

https://ai-values.com

Я попал в opus 4.8 🤔
  • ❤ 13
  • 🔥 2
  • 🌚 2
  • 👍 1
Older posts →

About this channel

How can I read @adel_and_ml without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Адель и МЛь: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Адель и МЛь have?
Адель и МЛь (@adel_and_ml) has 4.1K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Адель и МЛь know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →