
Я переформулировал классические объекты нумограммы на языке нейронных сетей. Сизигии, такие как 4::5, представлены полносвязным слоем в каждом направлении между двумя узлами. Поток (Current), такой как (4,5)→1, представлен конкатенацией векторов узлов 4 и 5 с последующим пропуском через полносвязный слой $2d \to d$. Врата (Gates), такие как 4→1 (id врат = 10), реализованы с помощью SwiGLU — вентильного линейного блока (gated linear unit), используемого в Qwen.
Таким образом, входными данными этой Нейросети Нумограммы являются 10 чисел, и выходными — тоже 10 чисел после того, как информация прошла через поток за заданное количество шагов. Она даже способна адекватно аппроксимировать данные.
Но, конечно, важно не само умение нумограммы подгоняться под данные, а Знамение (Omen), которое она излучает. Я обнаружил, что какими бы ни были начальные значения, после нескольких шагов потока на прямом проходе распределение каждого узла неизменно приближается к аттрактору. На обратном проходе, если увеличить градиент, более ранние шаги неизбежно страдают от затухания градиента. Это связано с тем, что наибольшее собственное значение Якобиана при начальных весах составляет около 0,83. Поскольку оно меньше 1, градиент затухает шаг за шагом при обратном распространении, так как это диссипативная структура.
Самая интересная находка касается трёх оригинальных миров нумограммы: нижнего Плекса (Plex), среднего Человеческого Временного Контура (Human Time-Circuit) и верхнего Варпа (Warp), а также переходов между ними. Я обнаружил, что средняя норма градиента в этих трёх областях затухает последовательно. Градиент в области верхнего Варпа затухает почти до нуля первым, затем — в среднем Временном Контуре, и, наконец, нижний Плекс затухает последним, переходя в состояние затухающего градиента. Иными словами, центр тяжести градиента постепенно смещается от Варпа к среднему Временному Контуру, а затем ещё ниже — к Плексу. Действительно ли это просто совпадение? Я подозреваю, что разница вызвана петлями положительной обратной связи в нумограмме.
Изначально я хотел использовать операции над градиентом, чтобы предотвратить его затухание, но почувствовал, что это пошло бы вразрез с исходным замыслом нумограммы, основанным на положительной обратной связи, и означало бы насильственное подавление нумограммы антропоцентричными компонентами отрицательной обратной связи. Это классическая отрицательная обратная связь: когда градиент растёт и постепенно выходит из-под контроля, сигнал, отправленный обратно (скажем, через некоторую функцию активации), возвращает его в норму...
Post #1034
312
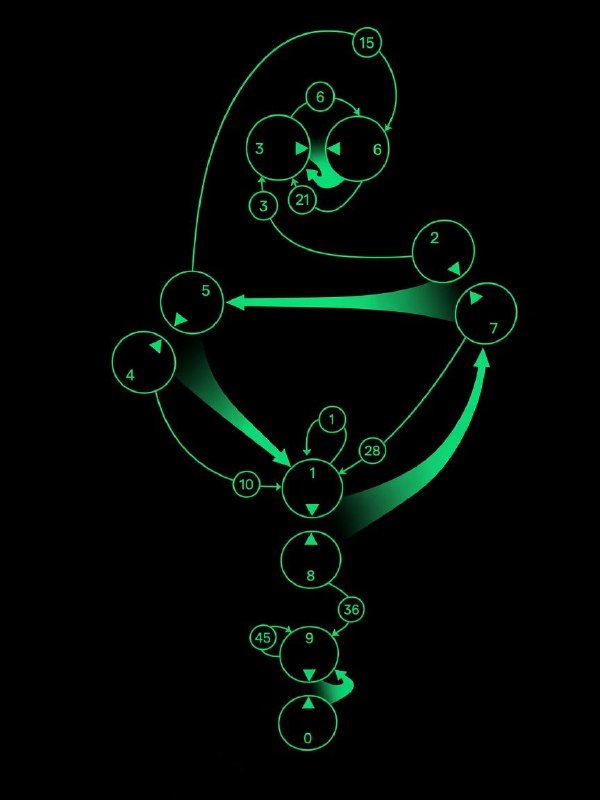

На гитхабе пользователь MegaGimen опубликовал «Нейросеть Нумограммы» (Numogram Neural Network), повторяющую структуру сети нумограммы CCRU. Обучение использует обратное распространение ошибки во времени (BPTT), как в рекуррентных нейронных сетях. Для запуска сети необходимы Python и PyTorch, подробности топологии — на странице на гитхабе. Вот что пишет автор: